仿真闭环
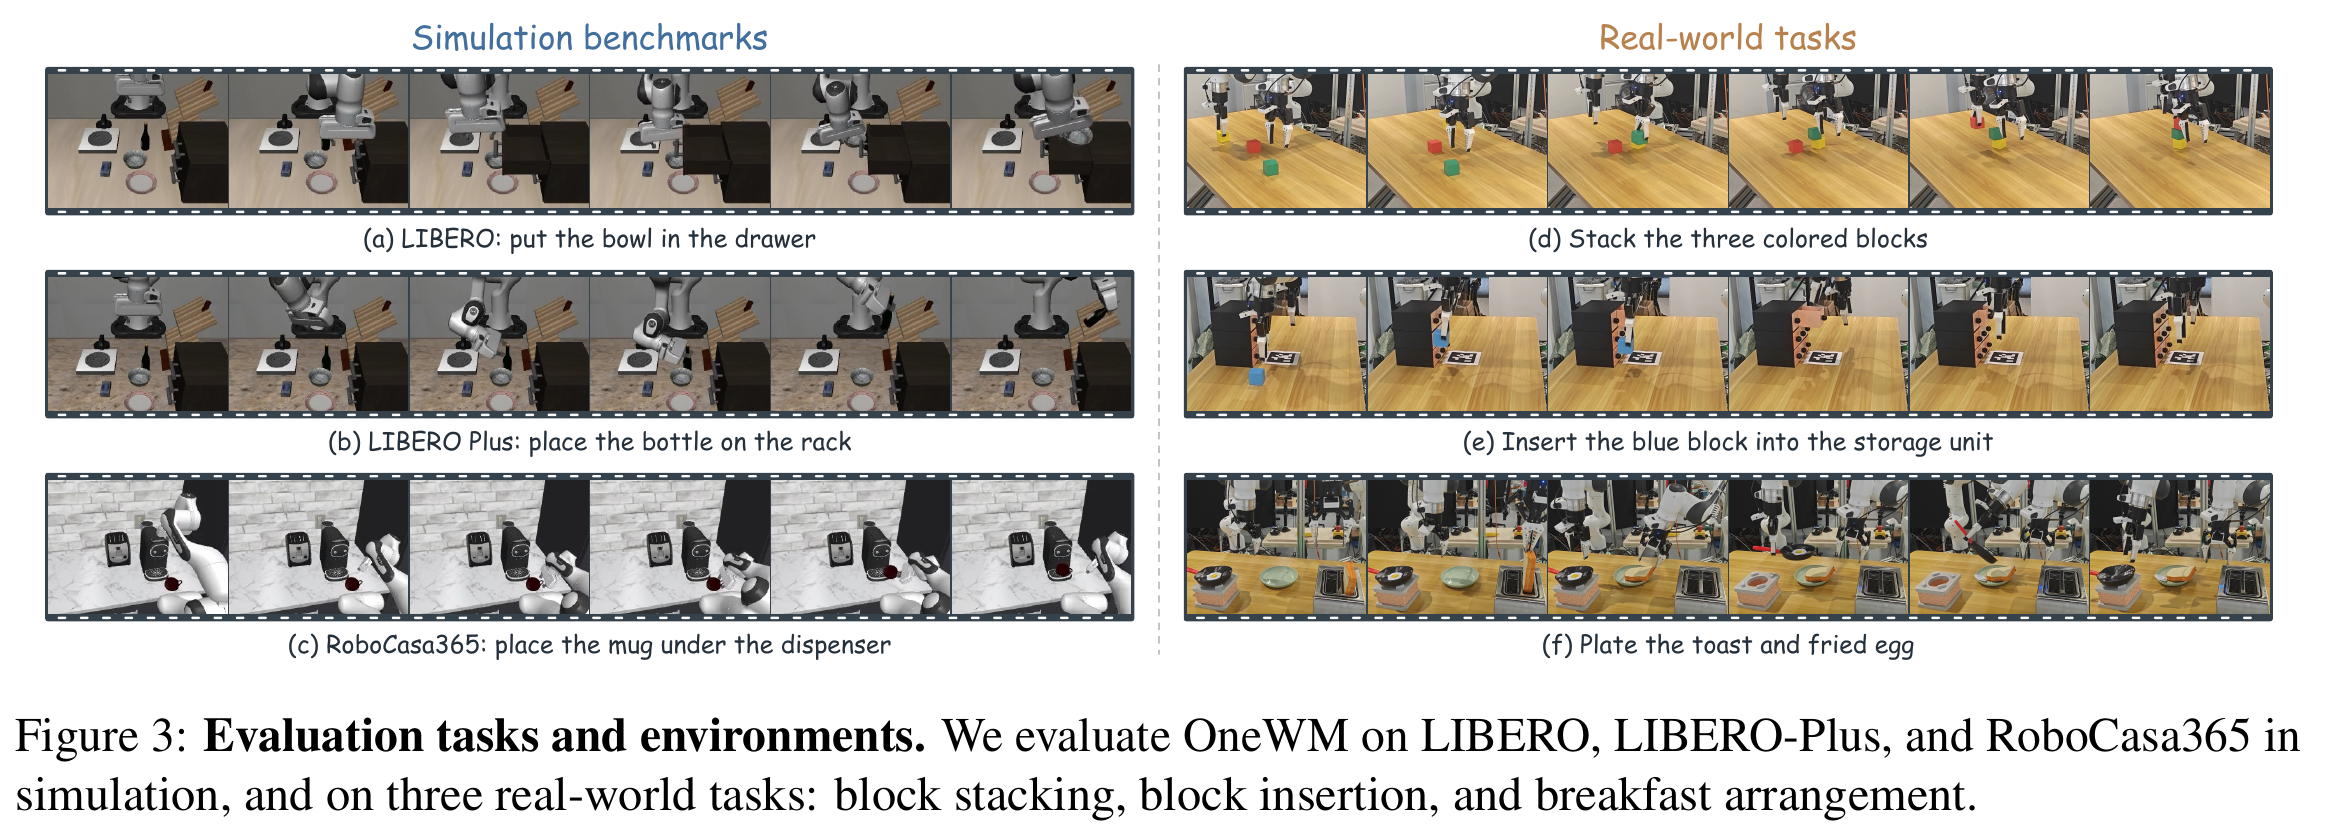
LIBERO 94.95%;LIBERO-Plus 59.27%;RoboCasa365 36.68%。强项是相对内部对照的提升,不是所有基准第一。
把动作既当作世界预测的已知条件,又当作策略需要生成的目标:训练中混合全干净、部分干净和全噪声动作,让前向动力学监督与动作监督互相帮助。部署策略不生成未来视频;收益不等于测试时先想象再行动。
“预测视频能帮助控制”已经不是新问题。这里追问:若未来视频只能看噪声动作,模型是否真正学到给定这个确定动作,世界会怎样变?反过来,让世界模型也学选动作,会不会损害视频质量?作者在同一架构中切换条件,尽量隔离这两种监督的作用。
| 问题 | 答案 |
|---|---|
| 背景 / 卡点 | 视频先验有效,但“视频与动作一起去噪”不自动等于“学习指定动作的前向动力学”。动作太噪或被 mask,动作到视觉的条件就不明确。 |
| 站在哪些工作上 | Wan2.2-TI2V-5B+原 VAE/文本编码器;MoT 分模态专家;flow matching;因果 WAM。与 Fast-WAM 的联系是训练时视频监督、部署轻量化,而不是同一 mask。 |
| 核心改动 | 同一因果结构,混合 all-noisy / partial-clean / all-clean=60/25/15;干净动作条件把“指定控制的后果”变成显式目标。 |
| 最有力证据 | 内部 WAMmask、WAMnoisy、WM 对照固定数据和训练预算;分别检验世界→策略与策略→世界。外部模型排名不能替代这些对照。 |
| 代价 / 未知 | 训练仍需视频专家与未来监督。报告没有完整给出参数总量、训练 GPU 总耗、真机控制频率和端到端延迟。 |
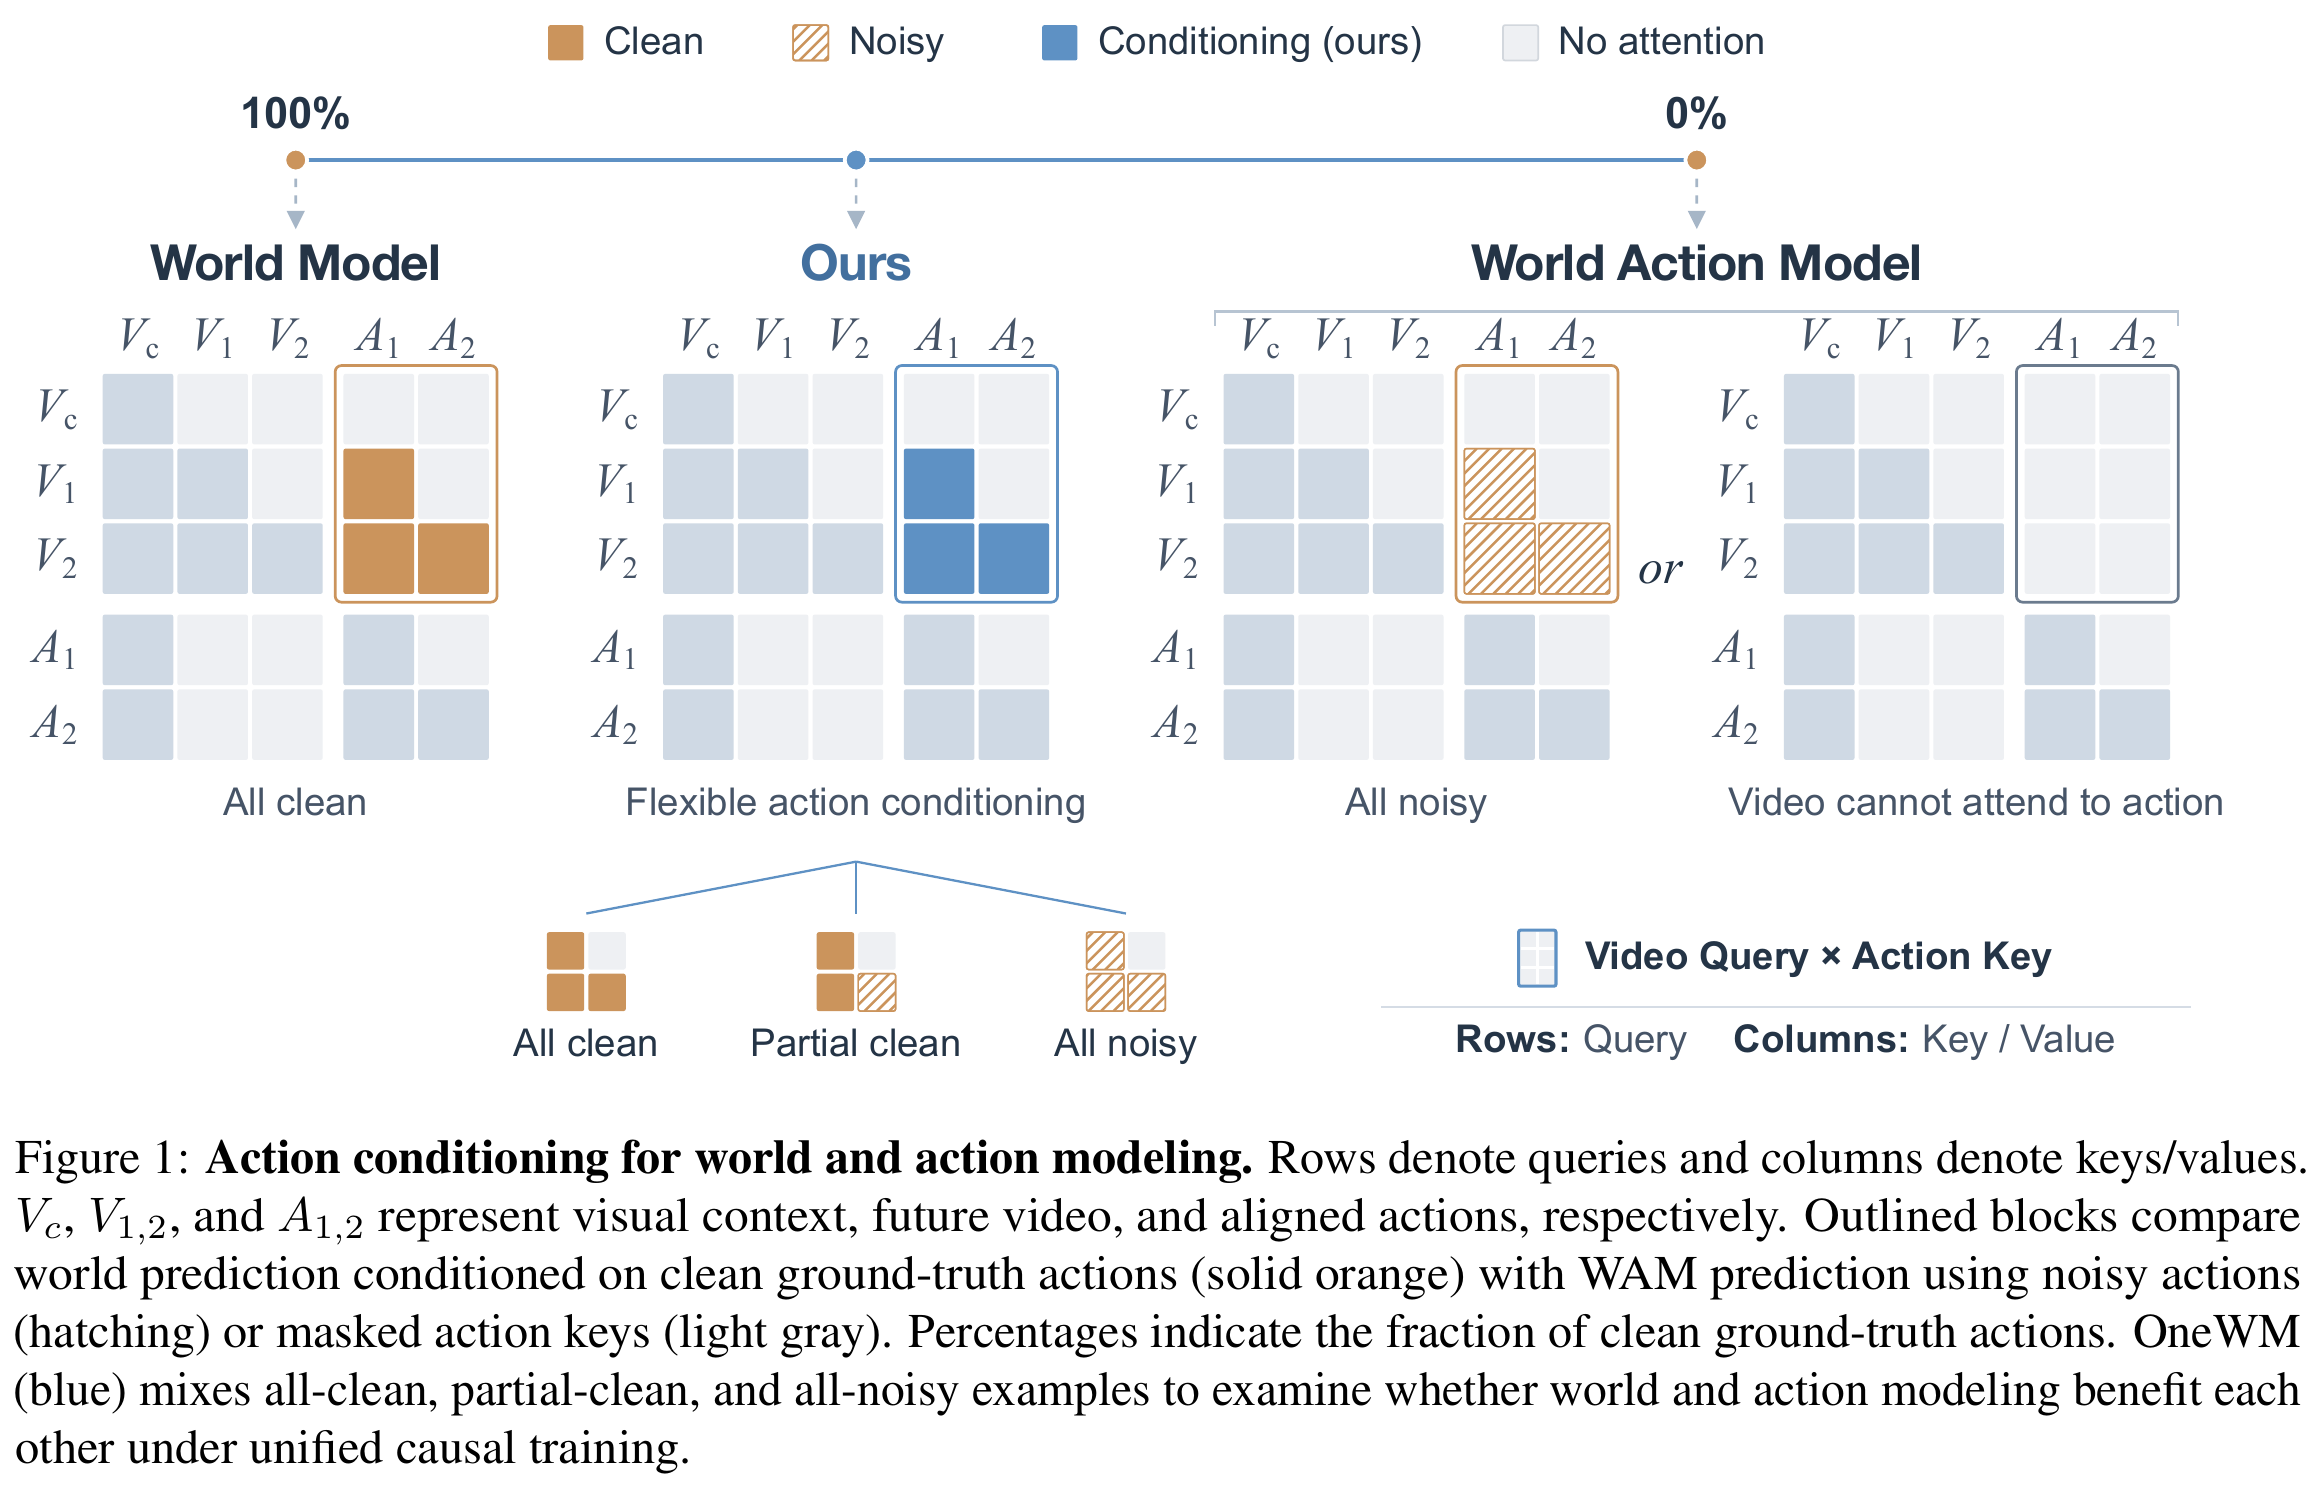
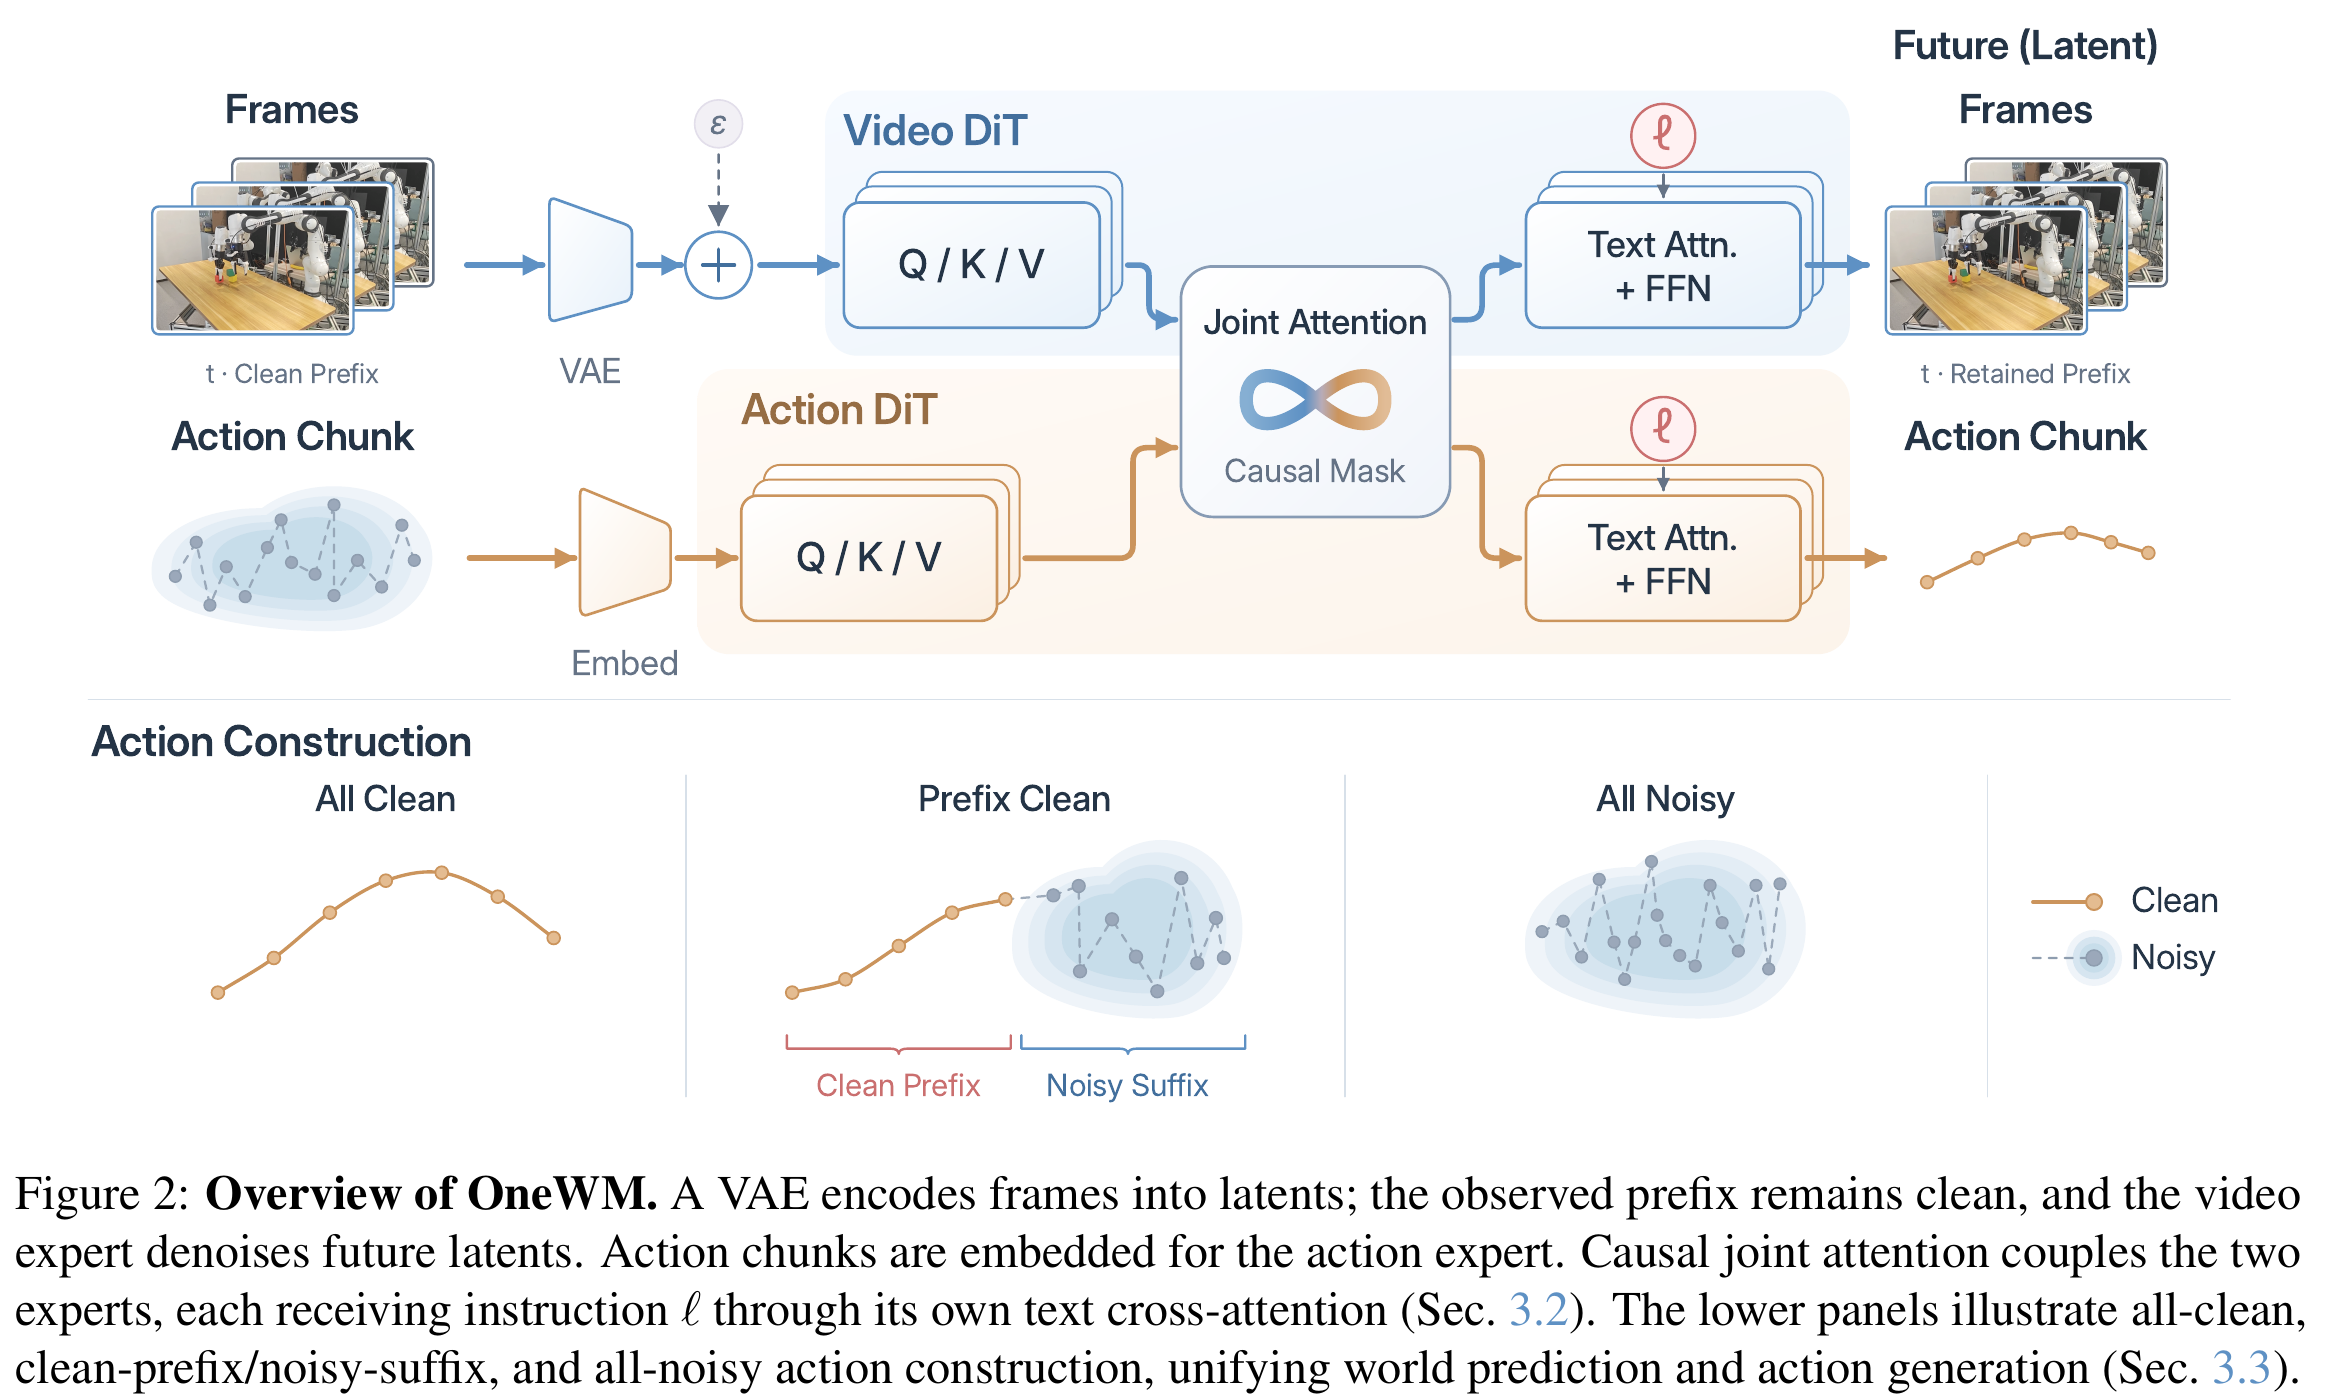
上一节说明动作有两种角色。现在拆开图中各流:图像先编码,两个专家各自处理 token,联合注意力用 mask 规定能读取谁。这里的关键不是 MoT 名字,而是动作是否能访问未来。
下文 i/k 是轨迹中的时间块或动作位置;τ 是去噪进度。τ 从 1 到 0 不意味着机器人倒着走。所有数字算例均为教学例子,不是论文实验。
V₀ 是观察,Vᵢ 是第 i 个未来视频块,Aᵢ 是对齐动作段;S 是该 Query 可见的 Key 集合。视频可以看已经对齐的动作,动作则只能看观察和动作前缀;块内允许自由交互,块间遵循时序。观察 Query 只留在观察流内。
m 表示视频或动作专家;Q/K/V 是各专家投影得到的查询、键、值,不是原始像素。d 是每个 attention head 的键维度。拼接发生在 token 轴,各路仍有自己的参数。mask 让不可见项的权重归零,再对可见项归一化。
r 是干净前缀长度,取 0…K。r=K 学指定动作下的世界;r=0 学完整策略;中间值学动作续写。干净 token 的 noise embedding 为零;后缀使用同一个采样的动作噪声水平。partial-clean 在对齐块边界附近与全范围均匀采样之间混合;具体二者比例未给出。
x 是干净目标,ε 是同形状高斯噪声;û 是模型预测的速度场。w 是随噪声水平变化的损失权重,λ 平衡模态。视频和动作各自采样 τ。动作损失只平均有后缀的样本;all-clean 没有动作去噪损失。具体 λ、w 配方未完整报告,不能默认都为 1。
E/D 是 VAE 编/解码,帽子表示生成值;j 是想象轮次。第一步生成动作,第二步把这些动作固定为干净条件预测视频,再取各相机末帧作下一轮观察。两个调用使用同一网络,不是同一次生成中用未来视频去修正当前动作。
它训练了策略复用的观察/交互表征,且视频能读取动作特征,梯度可以影响相连的专家。改善效果由内部对照支持;“哪一类表示变化占主要贡献”仍是机制解释,并没有被独立因果实验完全证明。
60/25/15 是同一数据里的动作条件构造比例,不是 robot/human/simulation 小时比例。本文没有大规模人类视频混训实验,不应和 OpenWAM/UniWAM 数据表混为一谈。
| 阶段 | 数据 / 预算 | 使用方式 / 边界 |
|---|---|---|
| 初始化 | 预训练 Wan2.2-TI2V-5B,复用 VAE 与文本编码器 | 不是从零训练视频生成器;上游视频预训练的数据成本不为零。 |
| LIBERO | 四套示范联合训练,20 epochs,global batch 128 | 直接测试 LIBERO-Plus,不在 Plus 做适配。 |
| RoboCasa365 | 90k optimizer steps,global batch 1024 | 示范集训练;区分 seen atomic / seen composite / unseen composite。 |
| 真机 | 三任务各 50 条,总 150 条;20 epochs,global batch 96 | 不是零样本真机迁移;用各任务示范训练。 |
| 视频评测集 | LIBERO/Plus 合计 100 complete episodes,由 π₀.₅ 收集;RoboCasa 100 episodes,由 Xiaomi-Robotics-1 收集 | 专家 rollout 构造的评测视频,不是论文另发大规模世界模型训练集。 |
| 动作条件模式 | all-noisy 60% / partial-clean 25% / all-clean 15% | 按样本混入 batch;内控对比保持数据、batch 和训练预算一致。 |
| Benchmark / split | 任务、输入与控制 | OneWM | 内部对照 | 边界 |
|---|---|---|---|---|
| LIBERO / 四套 | 图像观察+语言;连续动作块;benchmark success。模拟 trials/seeds、完整控制 Hz 未在文中重述。 | Spatial 96.60 / Object 98.60 / Goal 96.80 / Long 87.80;均值 94.95% | WAMmask 92.45;WAMnoisy 92.60 | 相对内控 +2.50 / +2.35 pp;低于表中 Fast-WAM 97.60。 |
| RoboCasa365 | 复杂厨房静止/移动操作;按 seen/unseen 组合报告;精确每子组试验数未报告。 | Atomic-S 68.78 / Comp.-S 30.25 / Comp.-U 7.00;总 36.68% | WAMmask 55.89 / 19.63 / 6.00;总 28.32% | 总体 +8.36 pp;未见组合只有 +1 pp,仍很难。 |
| 观察/动作与终止 | 多视角图像;动作维度、horizon、安全终止细项未完整列出。 | 不能把视频评测的 32/16 步预测 chunk 自动当作所有部署的执行 chunk;缺失字段需代码再核验。 | ||
| 测试变化 | OneWM | WAMmask | WAMnoisy | 相对 mask 差值 |
|---|---|---|---|---|
| 背景 | 57.34 | 54.00 | 53.07 | +3.34 pp |
| 相机 | 18.39 | 11.13 | 10.82 | +7.26 pp,绝对表现仍低 |
| 语言 | 79.57 | 73.85 | 70.33 | +5.72 pp |
| 光照 | 79.86 | 84.24 | 81.87 | −4.38 pp,退步 |
| 布局 | 71.08 | 62.36 | 63.08 | +8.72 pp |
| 机器人初始化 | 47.81 | 47.68 | 49.68 | +0.13 pp,低于 noisy |
| 传感噪声 | 67.08 | 50.41 | 48.34 | +16.67 pp |
| Overall | 59.27 | 53.37 | 52.50 | +5.90 pp |
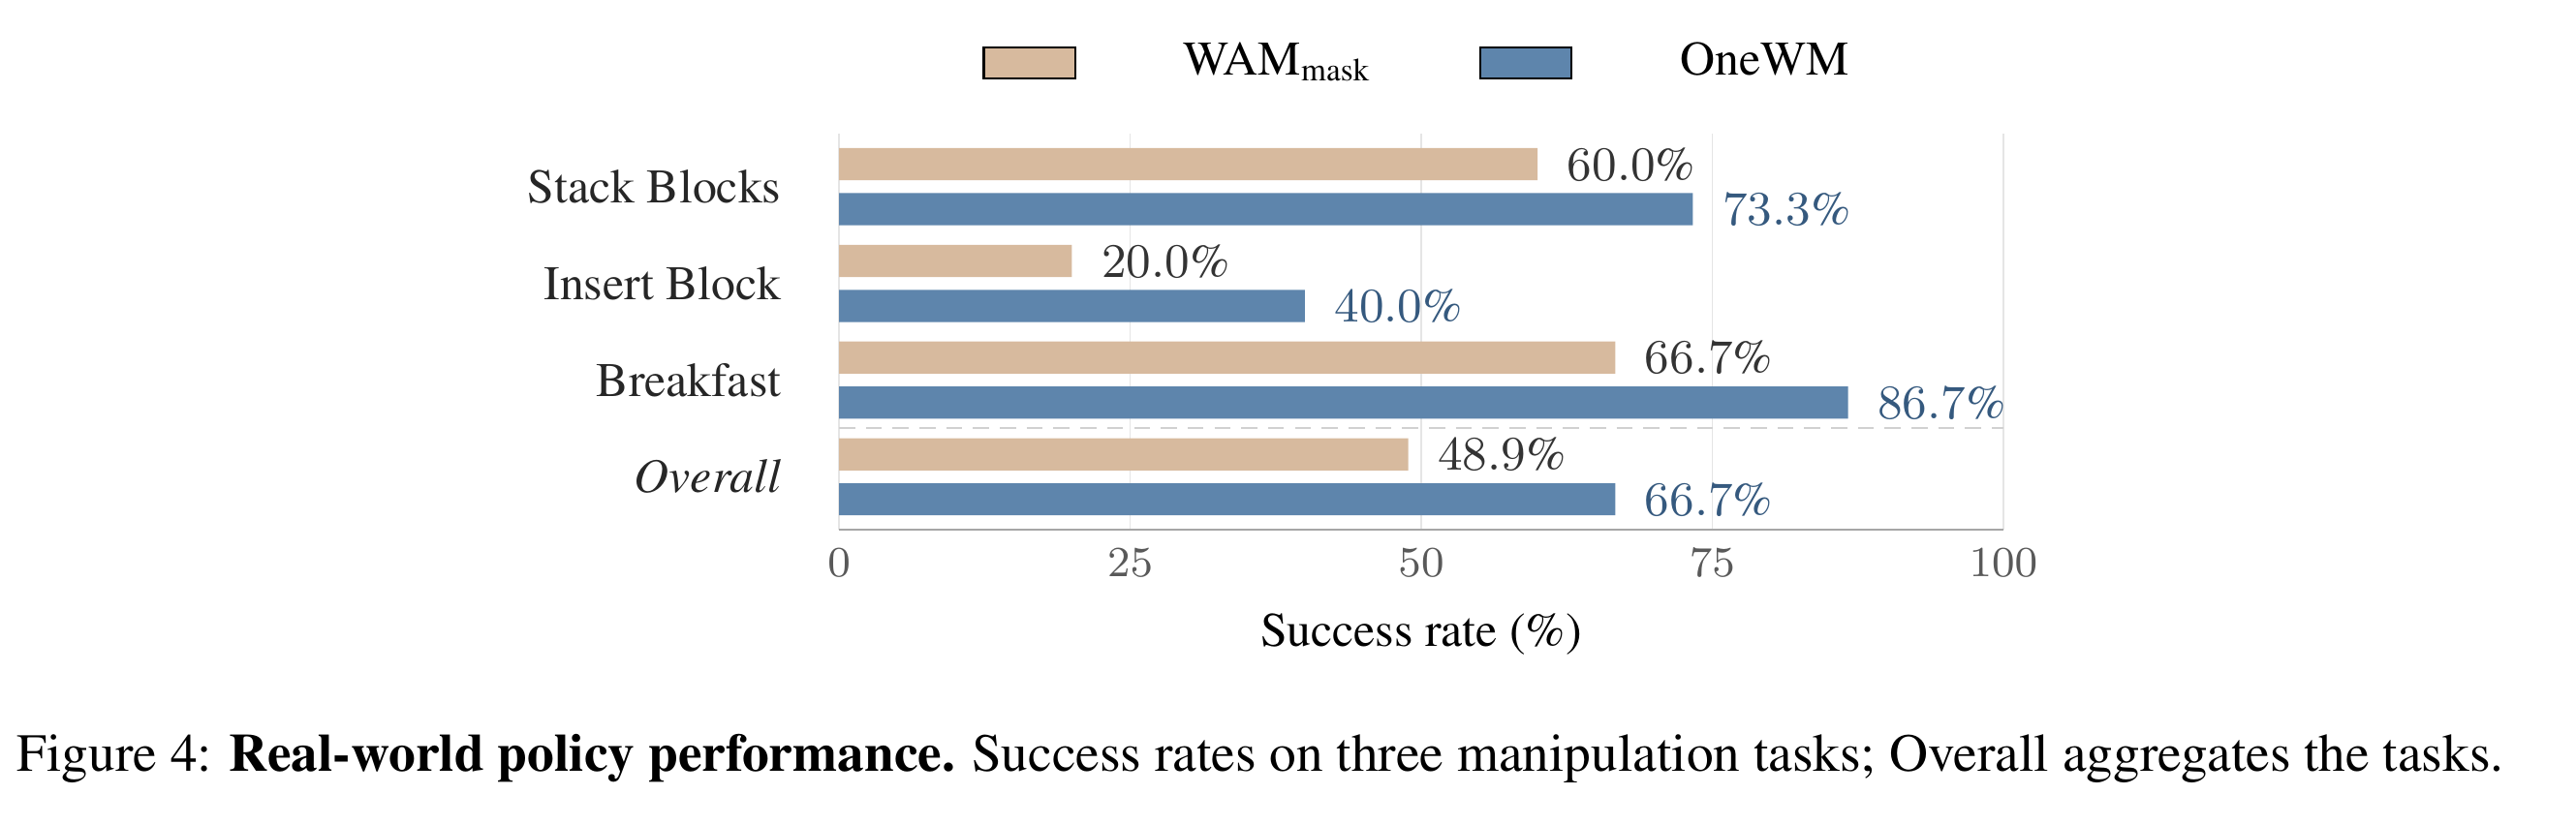
| 任务 | OneWM 成功 / 总数 | SR | Wilson 95% | WAMmask |
|---|---|---|---|---|
| 叠三色积木 | 11 / 15 | 73.3% | 48.0%–89.1% | 9 / 15 = 60.0% |
| 插入蓝块 | 6 / 15 | 40.0% | 19.8%–64.3% | 3 / 15 = 20.0% |
| 早餐摆盘 | 13 / 15 | 86.7% | 62.1%–96.3% | 10 / 15 = 66.7% |
| 合计 | 30 / 45 | 66.7% | 52.1%–78.6% | 22 / 45 = 48.9% |
真机经任务示范训练;不是 sim-to-real zero-shot。正文图片显示桌面操作,但机器人/夹爪型号、精确传感器规格、完成时间、干预/安全停止数和失败分类未完整报告。合计区间只是把这些试验聚合后的描述,不能代替分任务差异或多训练种子统计。
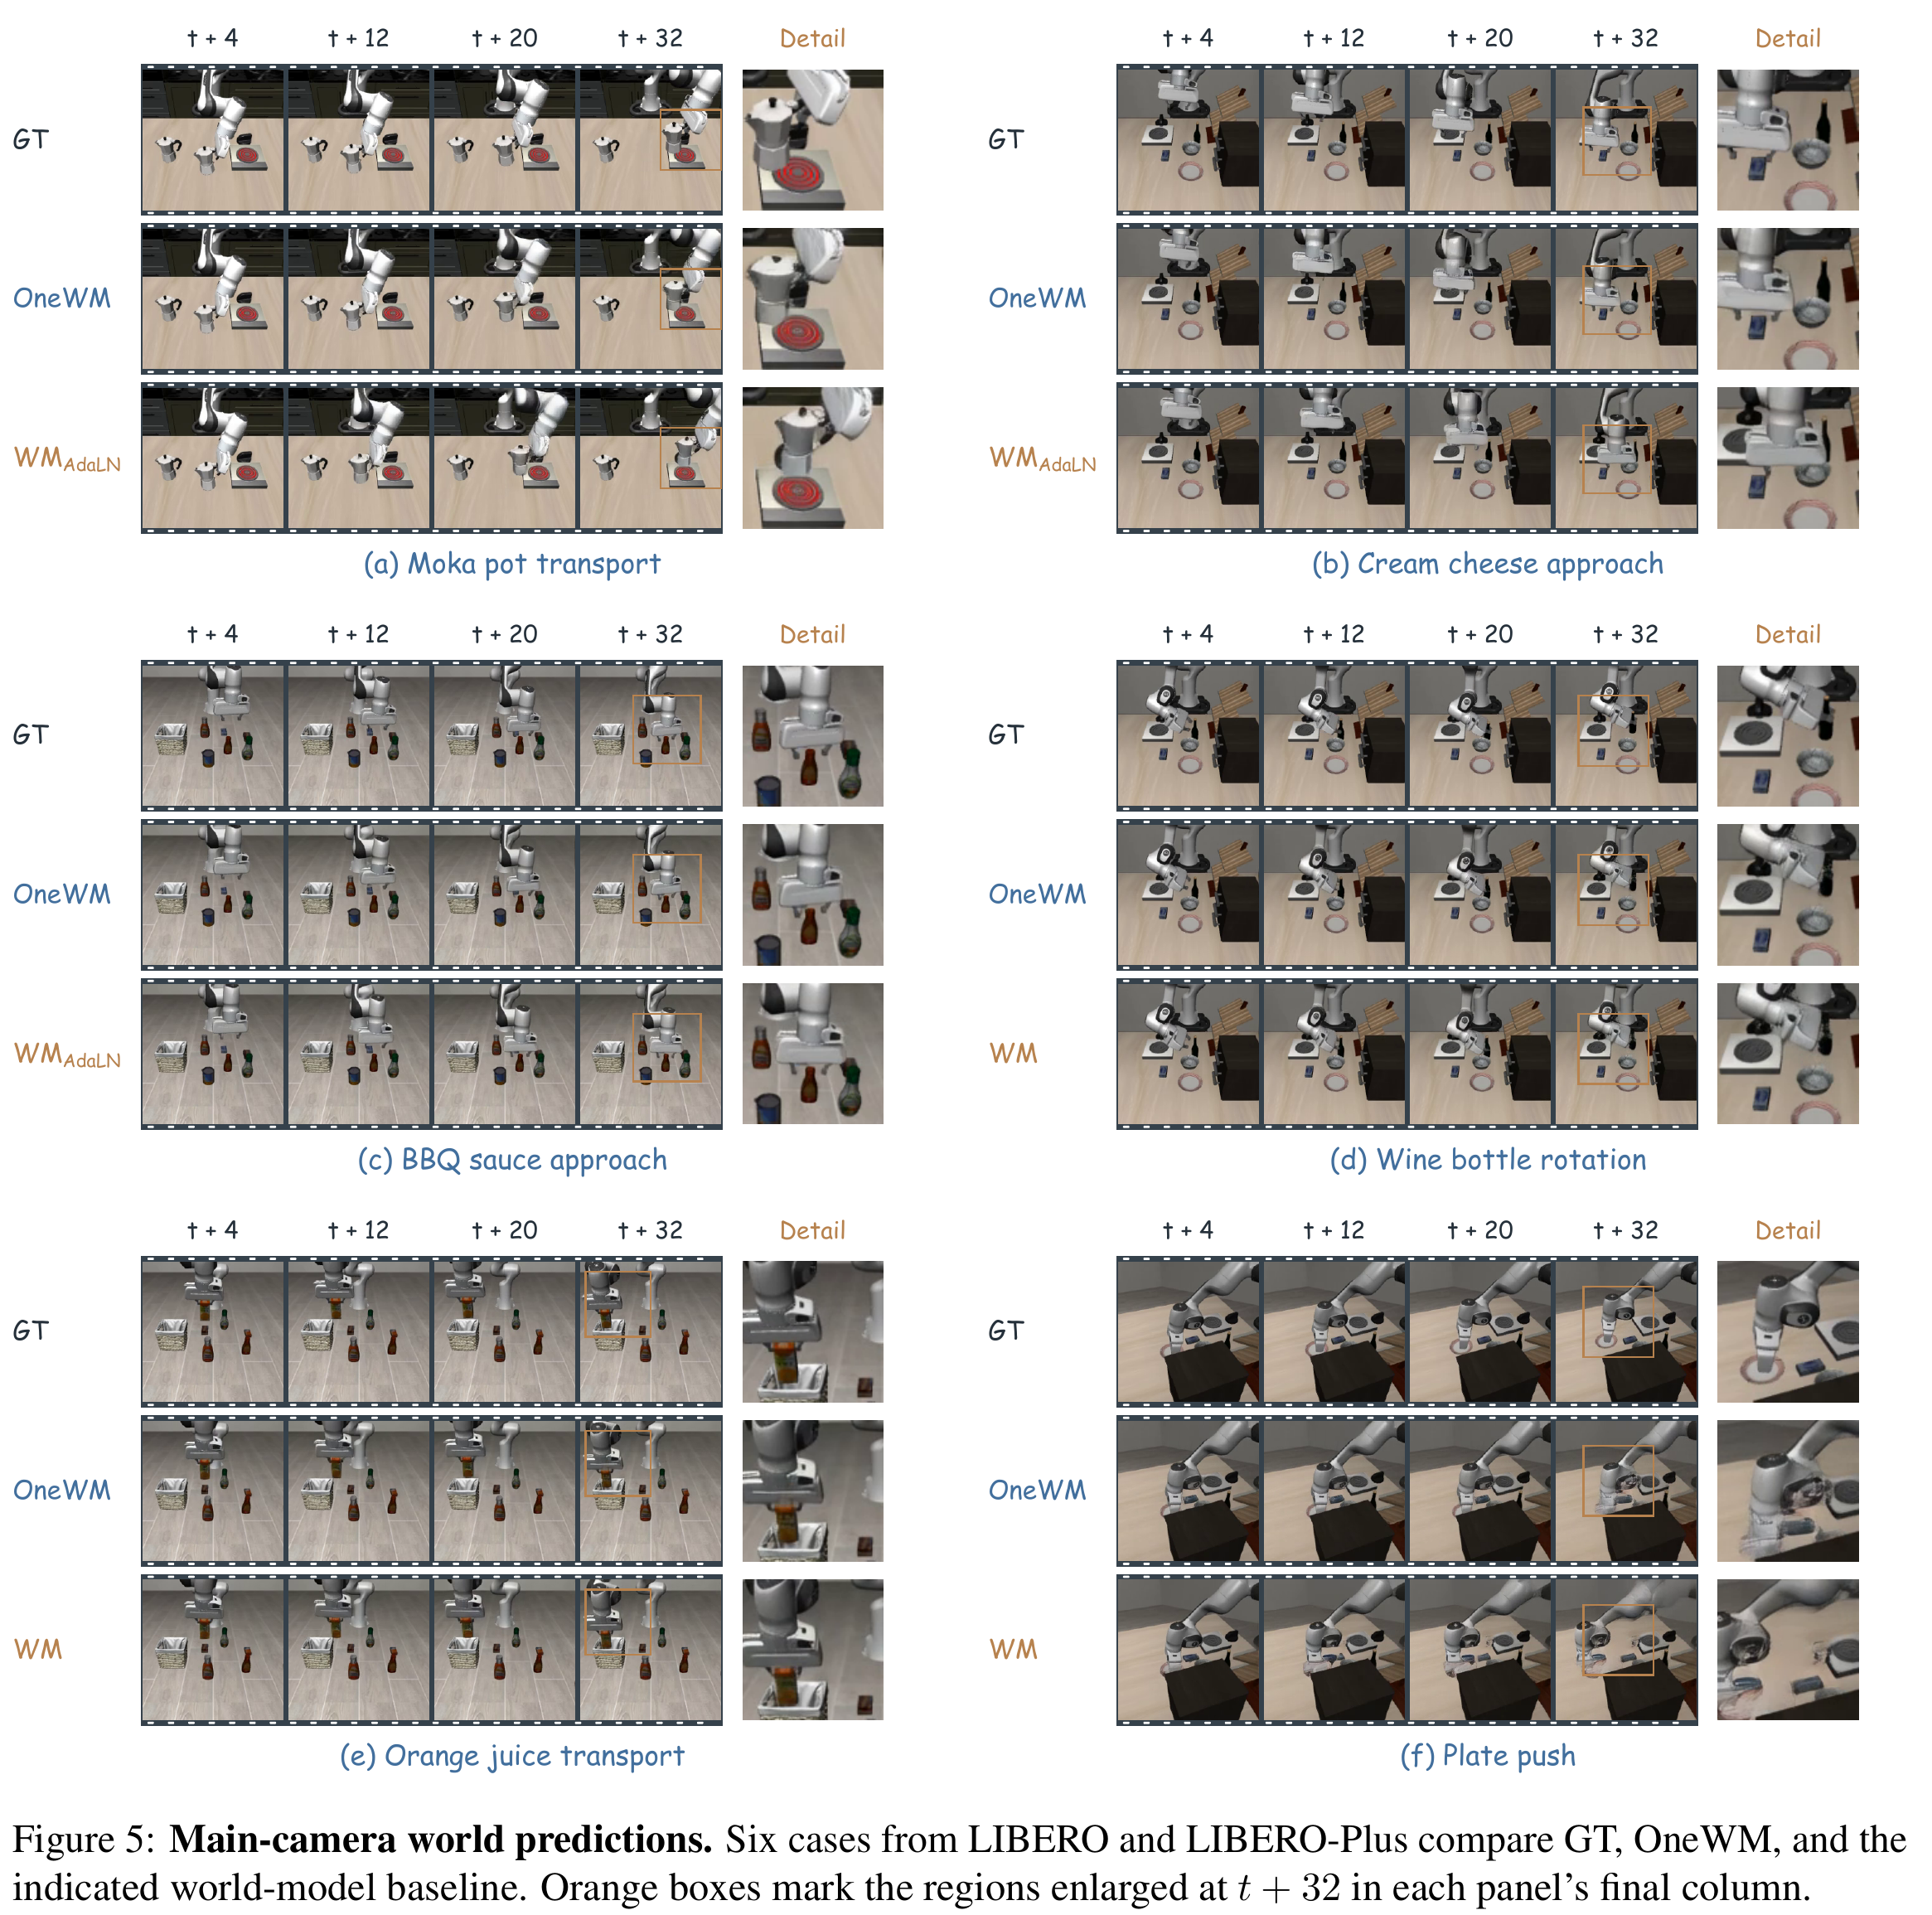
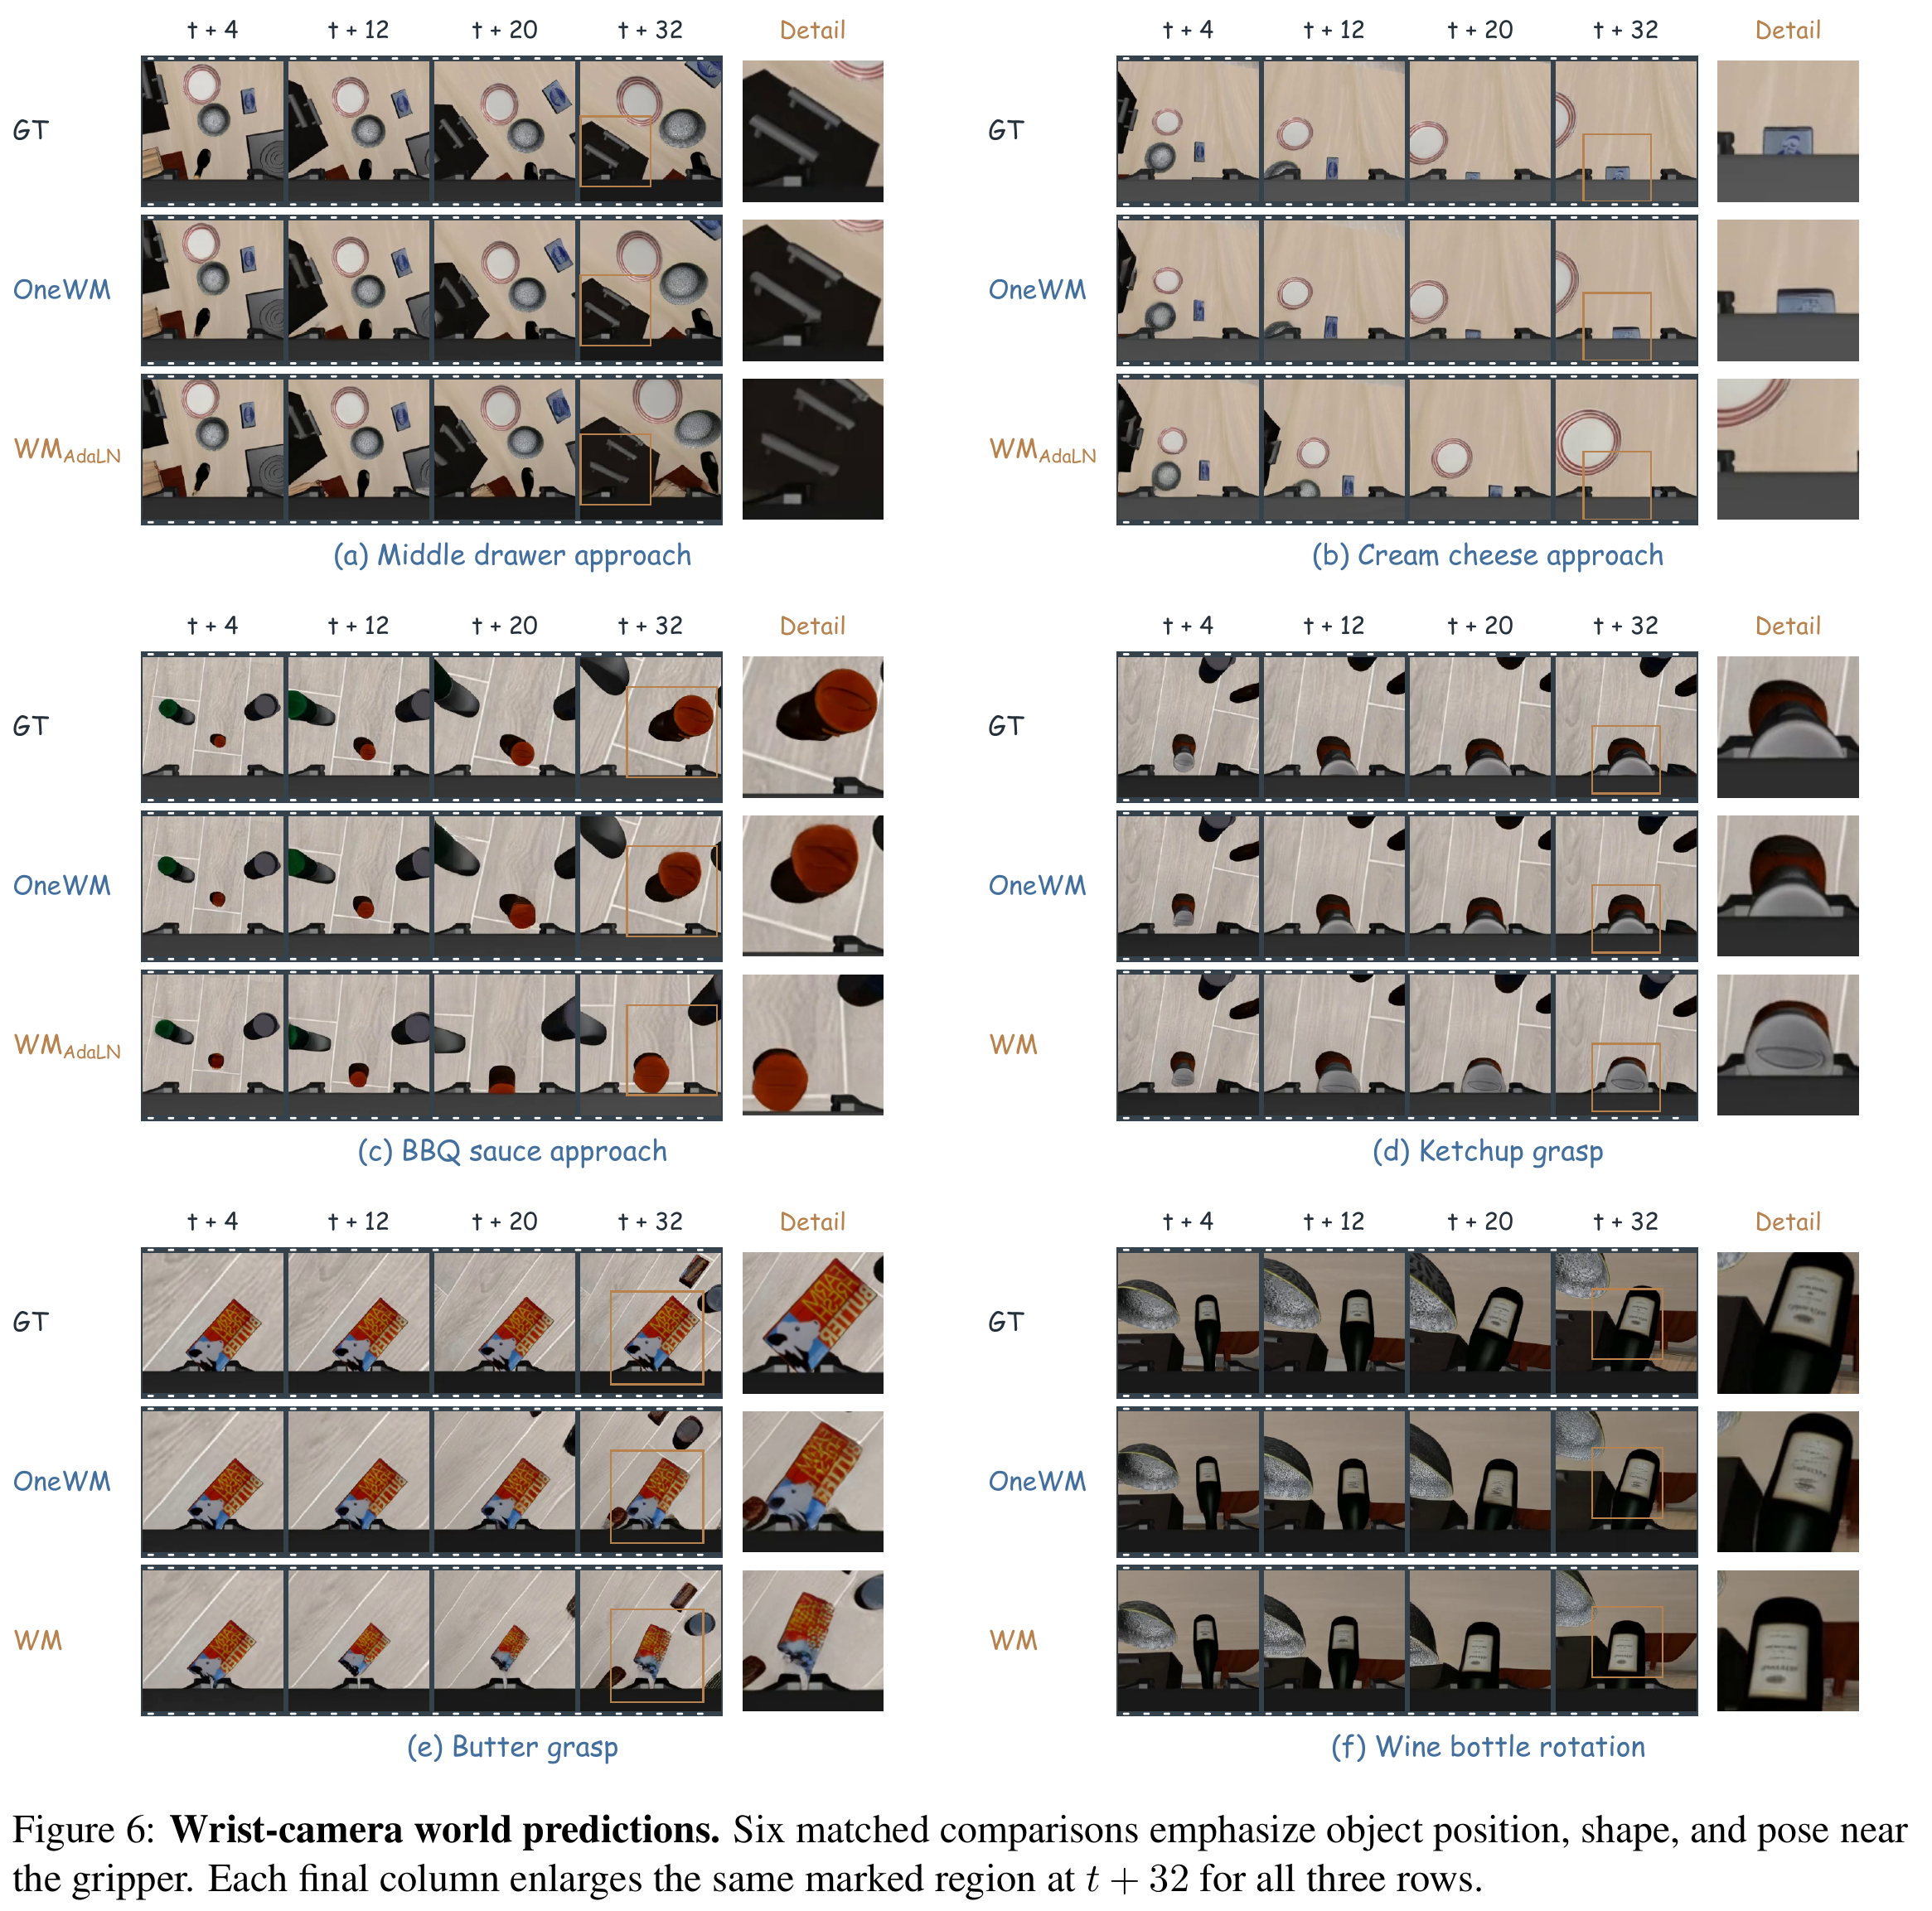
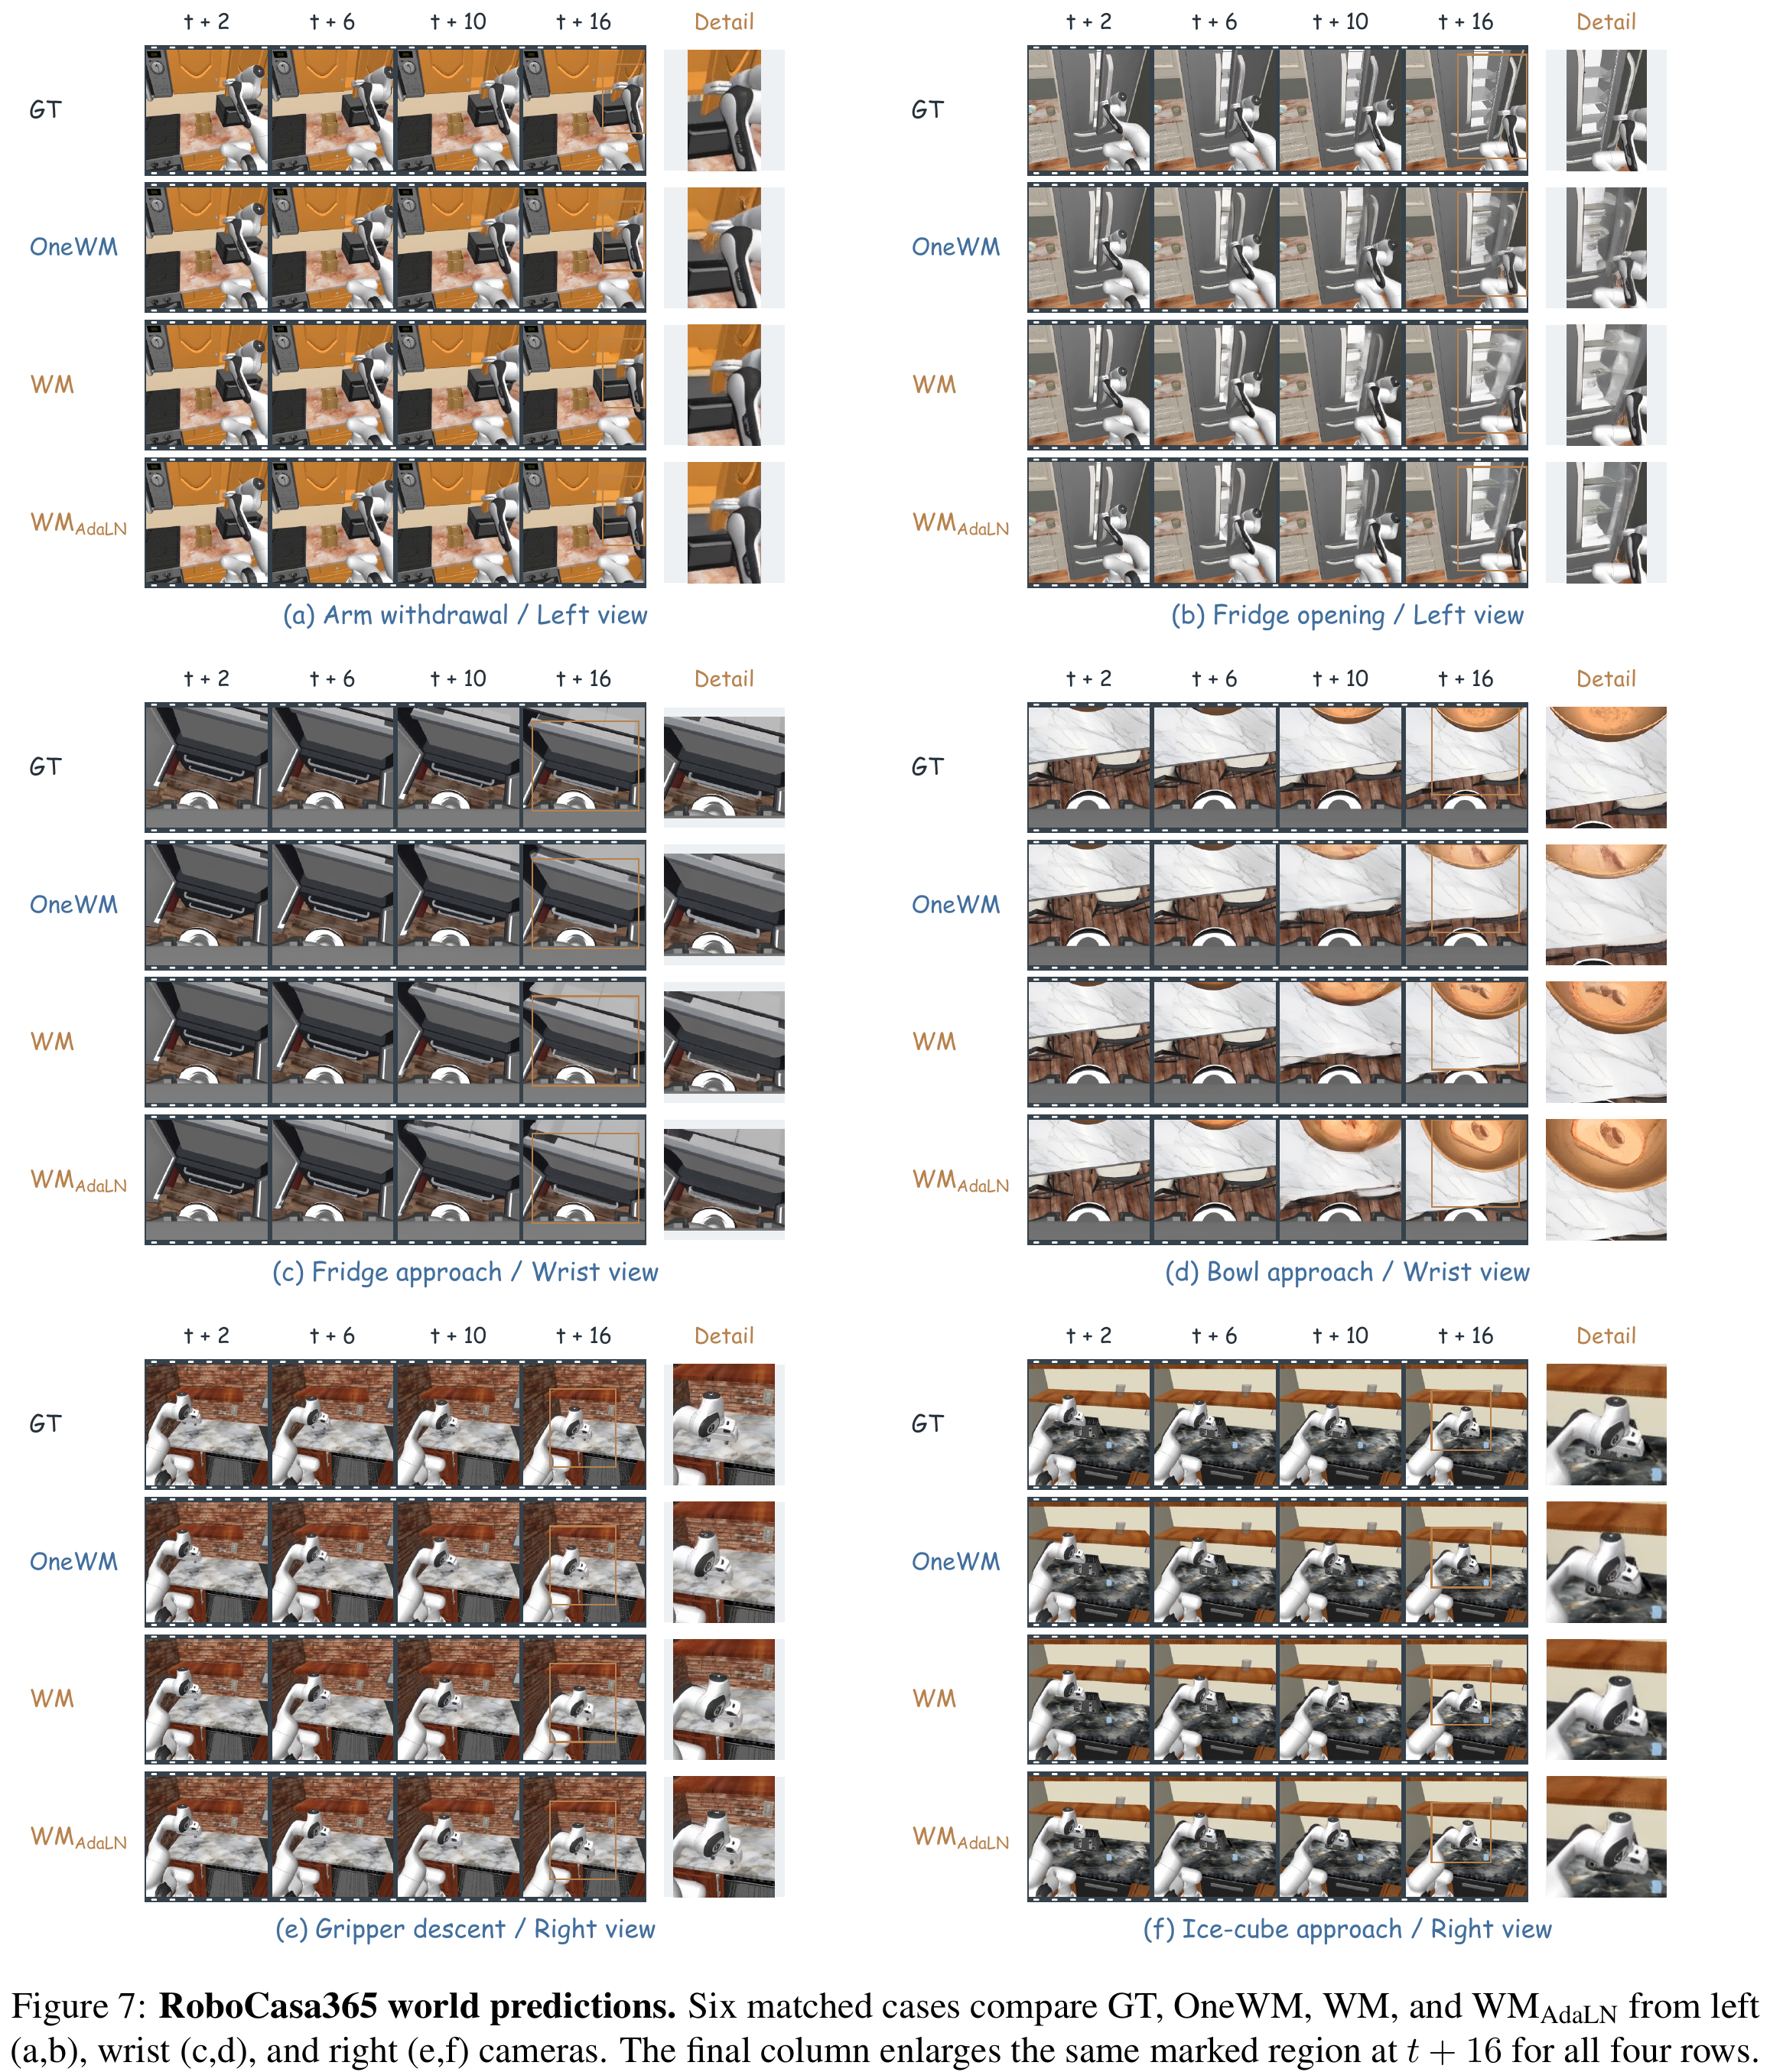
WM 和 OneWM 都拿到同一干净动作,预测未来多视角视频。差别在训练时有没有动作生成监督。这样才是在问“动作学习能否帮助世界模型”,而不是让两者拿到不同输入。
| Benchmark | PSNR↑ | SSIM↑ | LPIPS↓ | FID↓ | FVD↓ |
|---|---|---|---|---|---|
| LIBERO | 22.33 → 22.95 | .8325 → .8423 | .1529 → .1458 | 11.89 → 12.45(更差) | 13.68 → 13.58 |
| LIBERO-Plus | 20.54 → 21.05 | .7937 → .8049 | .2014 → .1935 | 18.06 → 17.01 | 32.48 → 31.66 |
| RoboCasa365 | 24.72 → 25.21 | .8433 → .8515 | .1087 → .1015 | 9.20 → 9.16 | 18.55 → 17.74 |
PSNR/SSIM/LPIPS 逐个预测与对应真值比较;FID/FVD 汇总特征分布。一个重要反例:把生成片段随机分配给不同动作,汇总分布不变,但动作—后果对应已错。因此“FID 更好”不能直接等于“更遵从动作”。OneWM 并非每项指标第一:WMAdaLN 在部分分布指标更强。
每个 chunk 8 个未来帧,不含条件帧;LIBERO/Plus 32 动作步、图像 stride 4;RoboCasa 16 步、stride 2。PSNR=−10log₁₀(MSE+10⁻⁸),RGB 范围 [0,1];SSIM 用 11×11 高斯窗口;LPIPS 用 PIQ VGG16。FID/FVD 先 H.264 QP20、YUV420p 编解码,分别提取 Inception-v3 2048D 与 Kinetics-400 I3D-R50 的 400D logits。后者不是可随意与其他 FVD 实现混比的通用标尺。
| 全噪 / 部分干净 / 全干净 | LIBERO SR | Plus SR | LIBERO PSNR | Plus PSNR |
|---|---|---|---|---|
| 60 / 25 / 15(默认) | 94.95 | 59.27 | 22.95 | 21.05 |
| 50 / 35 / 15 | 95.95 | 56.98 | 22.44 | 20.57 |
| 30 / 45 / 25 | 87.80 | 38.01 | 23.12 | 20.90 |
图像预测指标相近,策略尤其 OOD 却明显下降。作者解释为必须保留足够“动作未知、从噪声生成”的训练,匹配部署。干净动作是额外老师,不应该让模型只练“答案已给出”的题。这个解释合理,但论文只测试三组比例,没有证明 60/25/15 对其他模型和数据也最优。
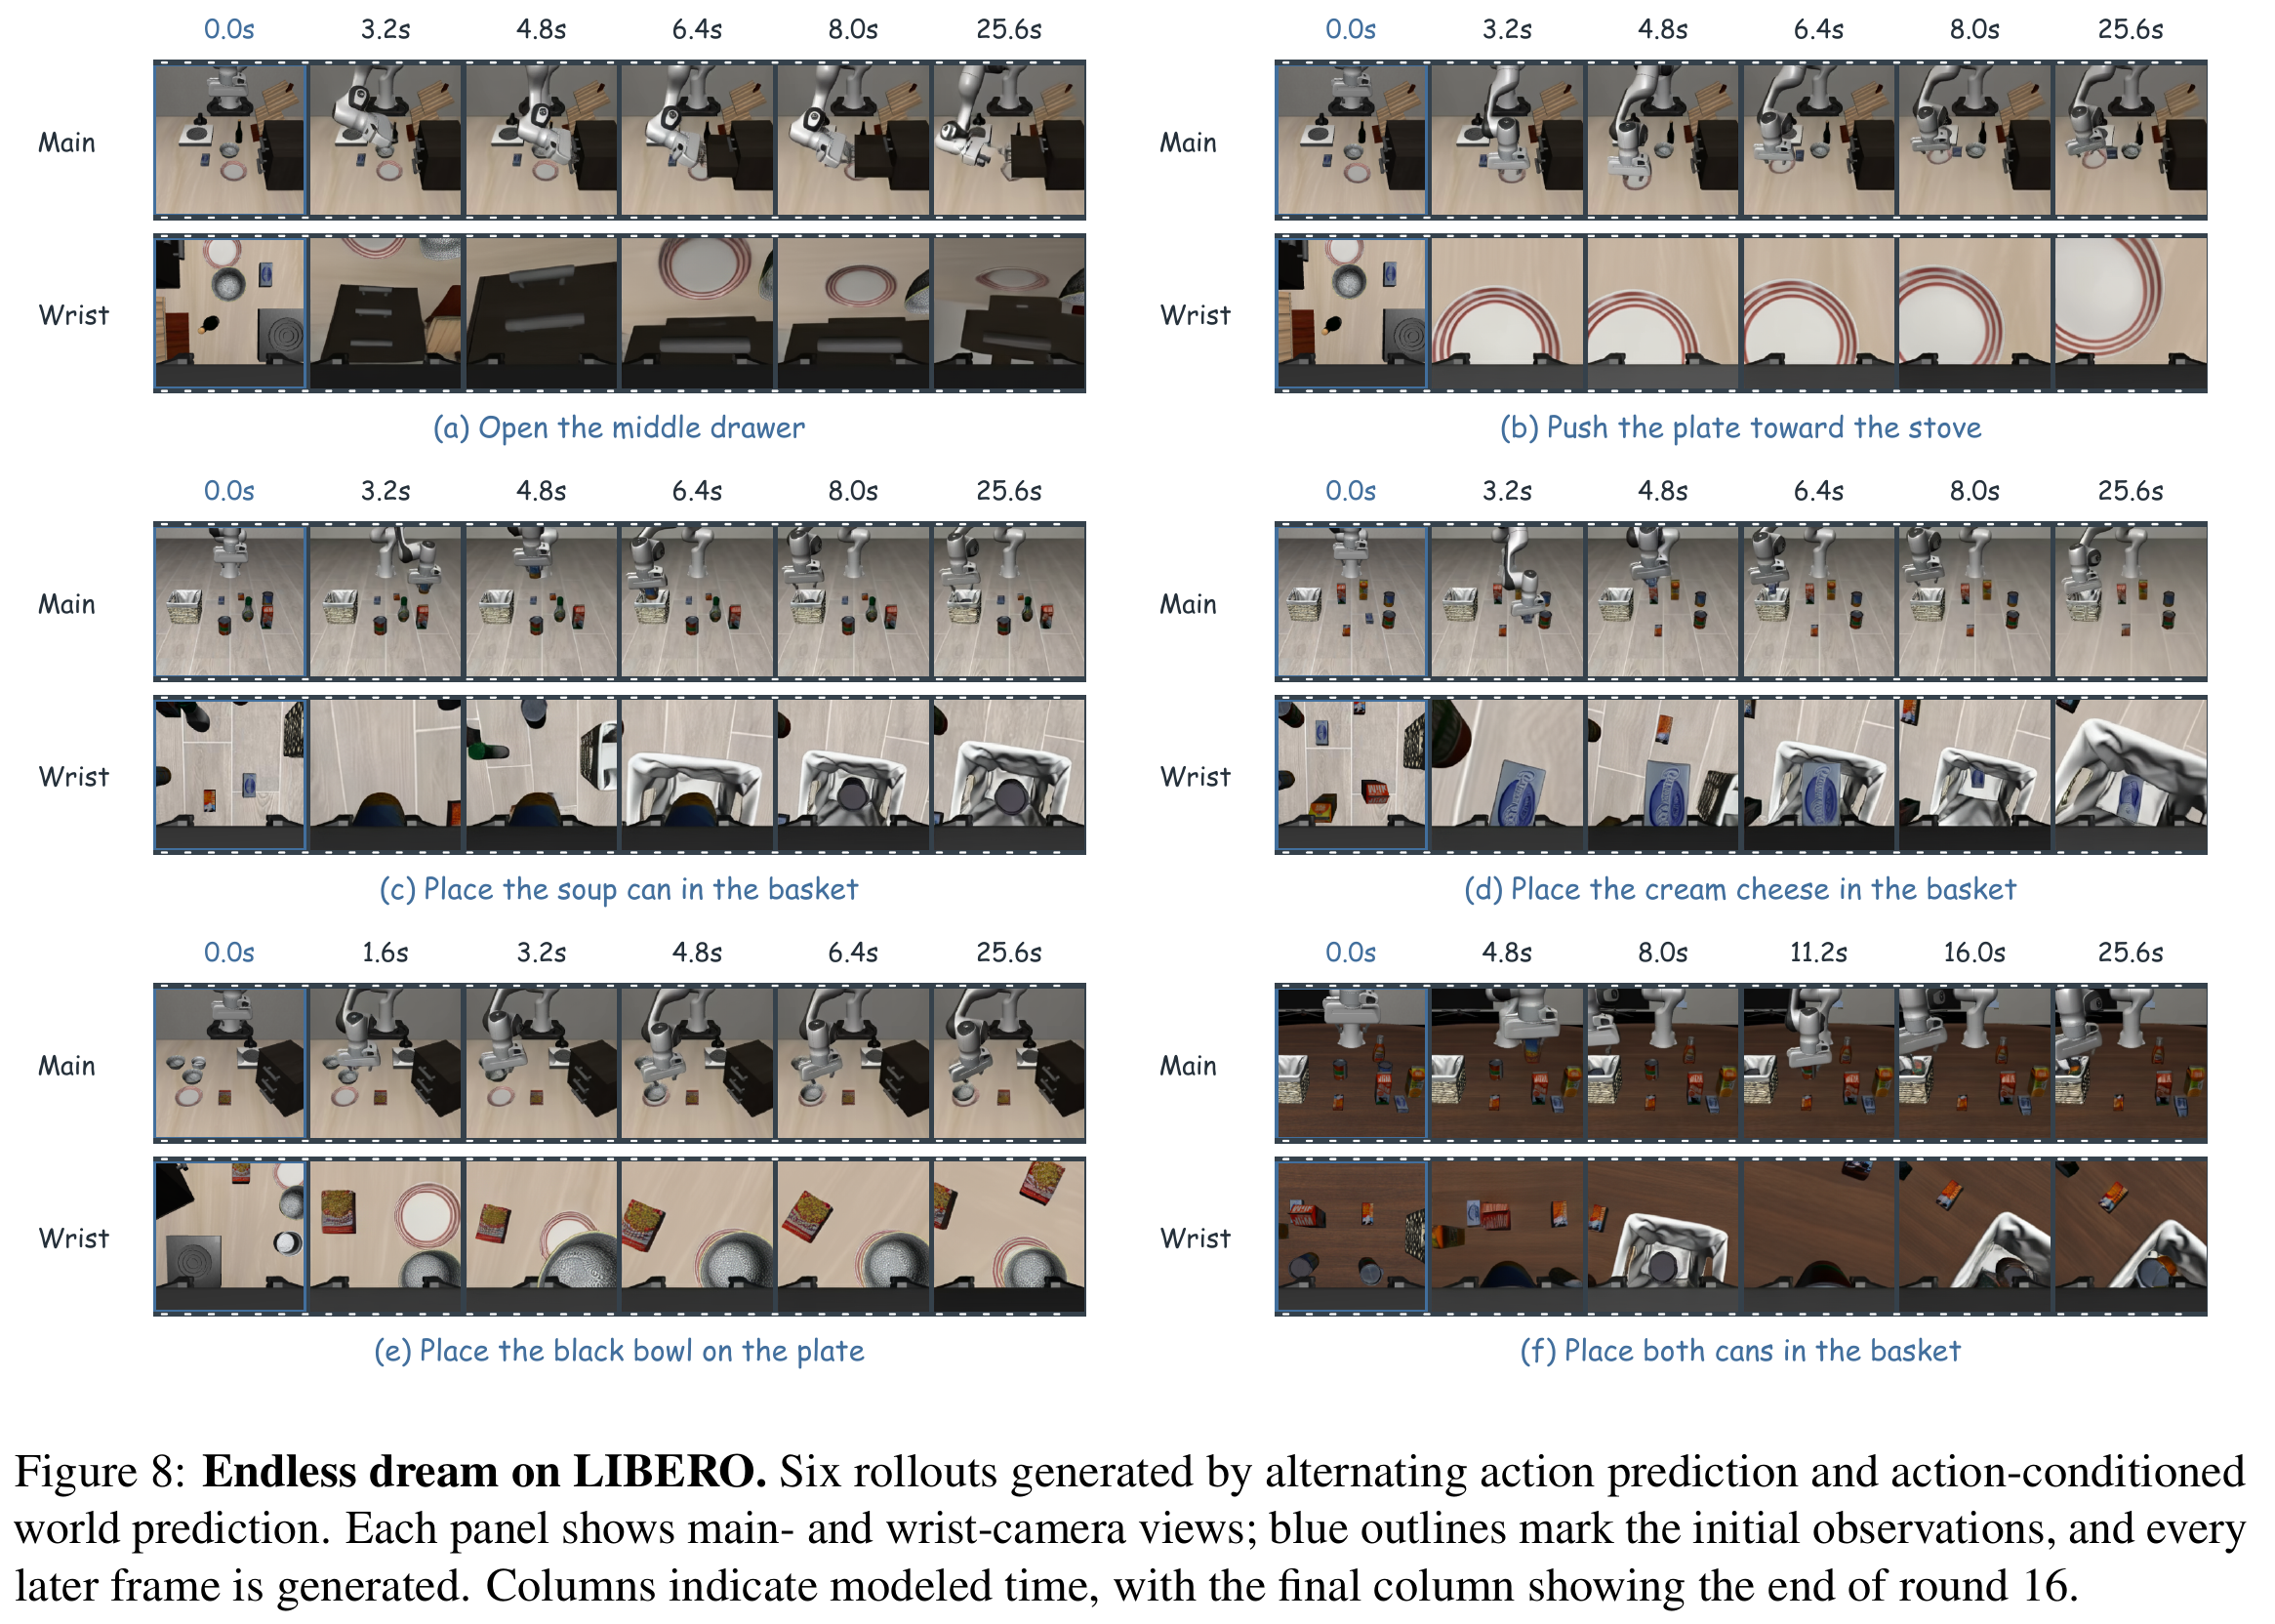
这是论文中唯一把两个推理模式交替接起来的展示。它没有再训练、也没有真实环境的每轮纠错。可支持“模型可以自生成连续的动作—视觉序列”;不支持“25.6 秒任务都能在真机成功”“已有可靠规划搜索”或“无需环境验证”。
| 主张 | 机制 | 证据 | 不能外推 |
|---|---|---|---|
| 世界帮助动作 | 指定干净控制的前向预测,改变共享表示与梯度 | Table 1;Fig 4;内控固定训练预算 | 不是所有 OOD 维度更好;未见组合仍 7% |
| 动作帮助世界 | 动作生成监督约束控制相关几何 | Table 2,同架构 WM 对照 | LIBERO FID 退步;表征因果路径未单独量化 |
| 两种能力可组合 | 策略/世界接口轮流调用 | Eq.6、Appendix C 六例 | 没有梦境准确率、真实长程成功率或规划收益 |
与 VLA / Embodied AI 的联系:最值得复用的是训练问题的设计:世界模型是否真的看见足够清晰的动作因果条件?辅助视觉损失是否在不增加部署成本时提供更好的控制表征?这比把“联合生成”当成固定架构标签更可操作。
原文表述核对:§4.2 说对 Fast-WAM 在所有 Plus 类别都更好,但 Table 1 光照为 OneWM 79.86、Fast-WAM 78.90,确实成立;对内部 WAMmask 光照则退步,不能把这两句话混用。arXiv 页边日期 10-15 与正文 Date 10-16 并存,元信息保留差异。不同论文里的 LIBERO-Plus 数字不能直接并榜,版本/任务/评测协议须另外核验。
可支持的最强结论:在这套 Wan 初始化的因果 MoT 与所测试预算下,加入明确动作条件的世界学习能改善策略,加入策略学习能改善多数世界预测指标。暂不能支持:任意规模的 scaling law、强跨本体迁移、普遍实时性,或未来想象是部署动作的必要条件。