数据引擎 / 时序标注与奖励模型 · OCTOBER 2026 READING SERIES

FLORA:把机器人视频变成可训练、可评分的数据

FLORA: An Open Model Suite for Scaling Robotics Data Engines · NVIDIA · Leng / Man / Li 等
官方PDF · 2026-10-20 · 37页,含附录A–H · 核读:2026-10-23

一句话核心洞见

把“什么时候发生什么”和“做得怎么样”拆成可验证的接口:先分段再用上下文写动作描述,同一个奖励模型按prompt提供结果、过程、rubric评分。价值是数据生产效率;标签质量提升到闭环机器人性能之间,仍需要独立实验。

定位
3个模型:9B分段、27B描述、27B奖励;不直接输出机器人动作。
标注
WGO分段50.3 / 联合34.5;Human联合37.4、Robot联合51.0。
奖励
RoboReward MAE0.40分;过程失败召回53.3%,正常帧误报约11%。
吞吐与成本
作者报告512GB300每天20万视频小时;约125×成本来自条件模型。

01 · FLORA在整条WAM链路的哪里?

原始视频有很多,但训练policy还需要知道“哪段在开抽屉”“哪只手拿着什么”“刚才是失败还是只是慢”。人工逐段标注贵,通用VLM又容易漏掉短动作、错配手角色、把最后成功倒灌成中间每一步都正确。FLORA把这些问题组织成可规模化部署的数据引擎。

术语先对齐:temporal segmentation=动作时间分段;contextual captioning=结合邻近视觉上下文描述当前动作;outcome reward=整段结果;dense/process reward=局部执行质量;rubric reward=按用户给的任务步骤评分。输出的是语义监督和评价信号,要生成机器人控制仍需另外训练policy。

它直接建立在Qwen3.5 VLM、两阶段视频标注和机器人奖励模型之上,和Refiner、LeRobot annotate、Pegasus等完整标注系统比较。作者称用于GR00T训练;本文给出标签指标和成本分析,但没有“使用FLORA标签前后,同一机器人闭环SR”的控制实验。
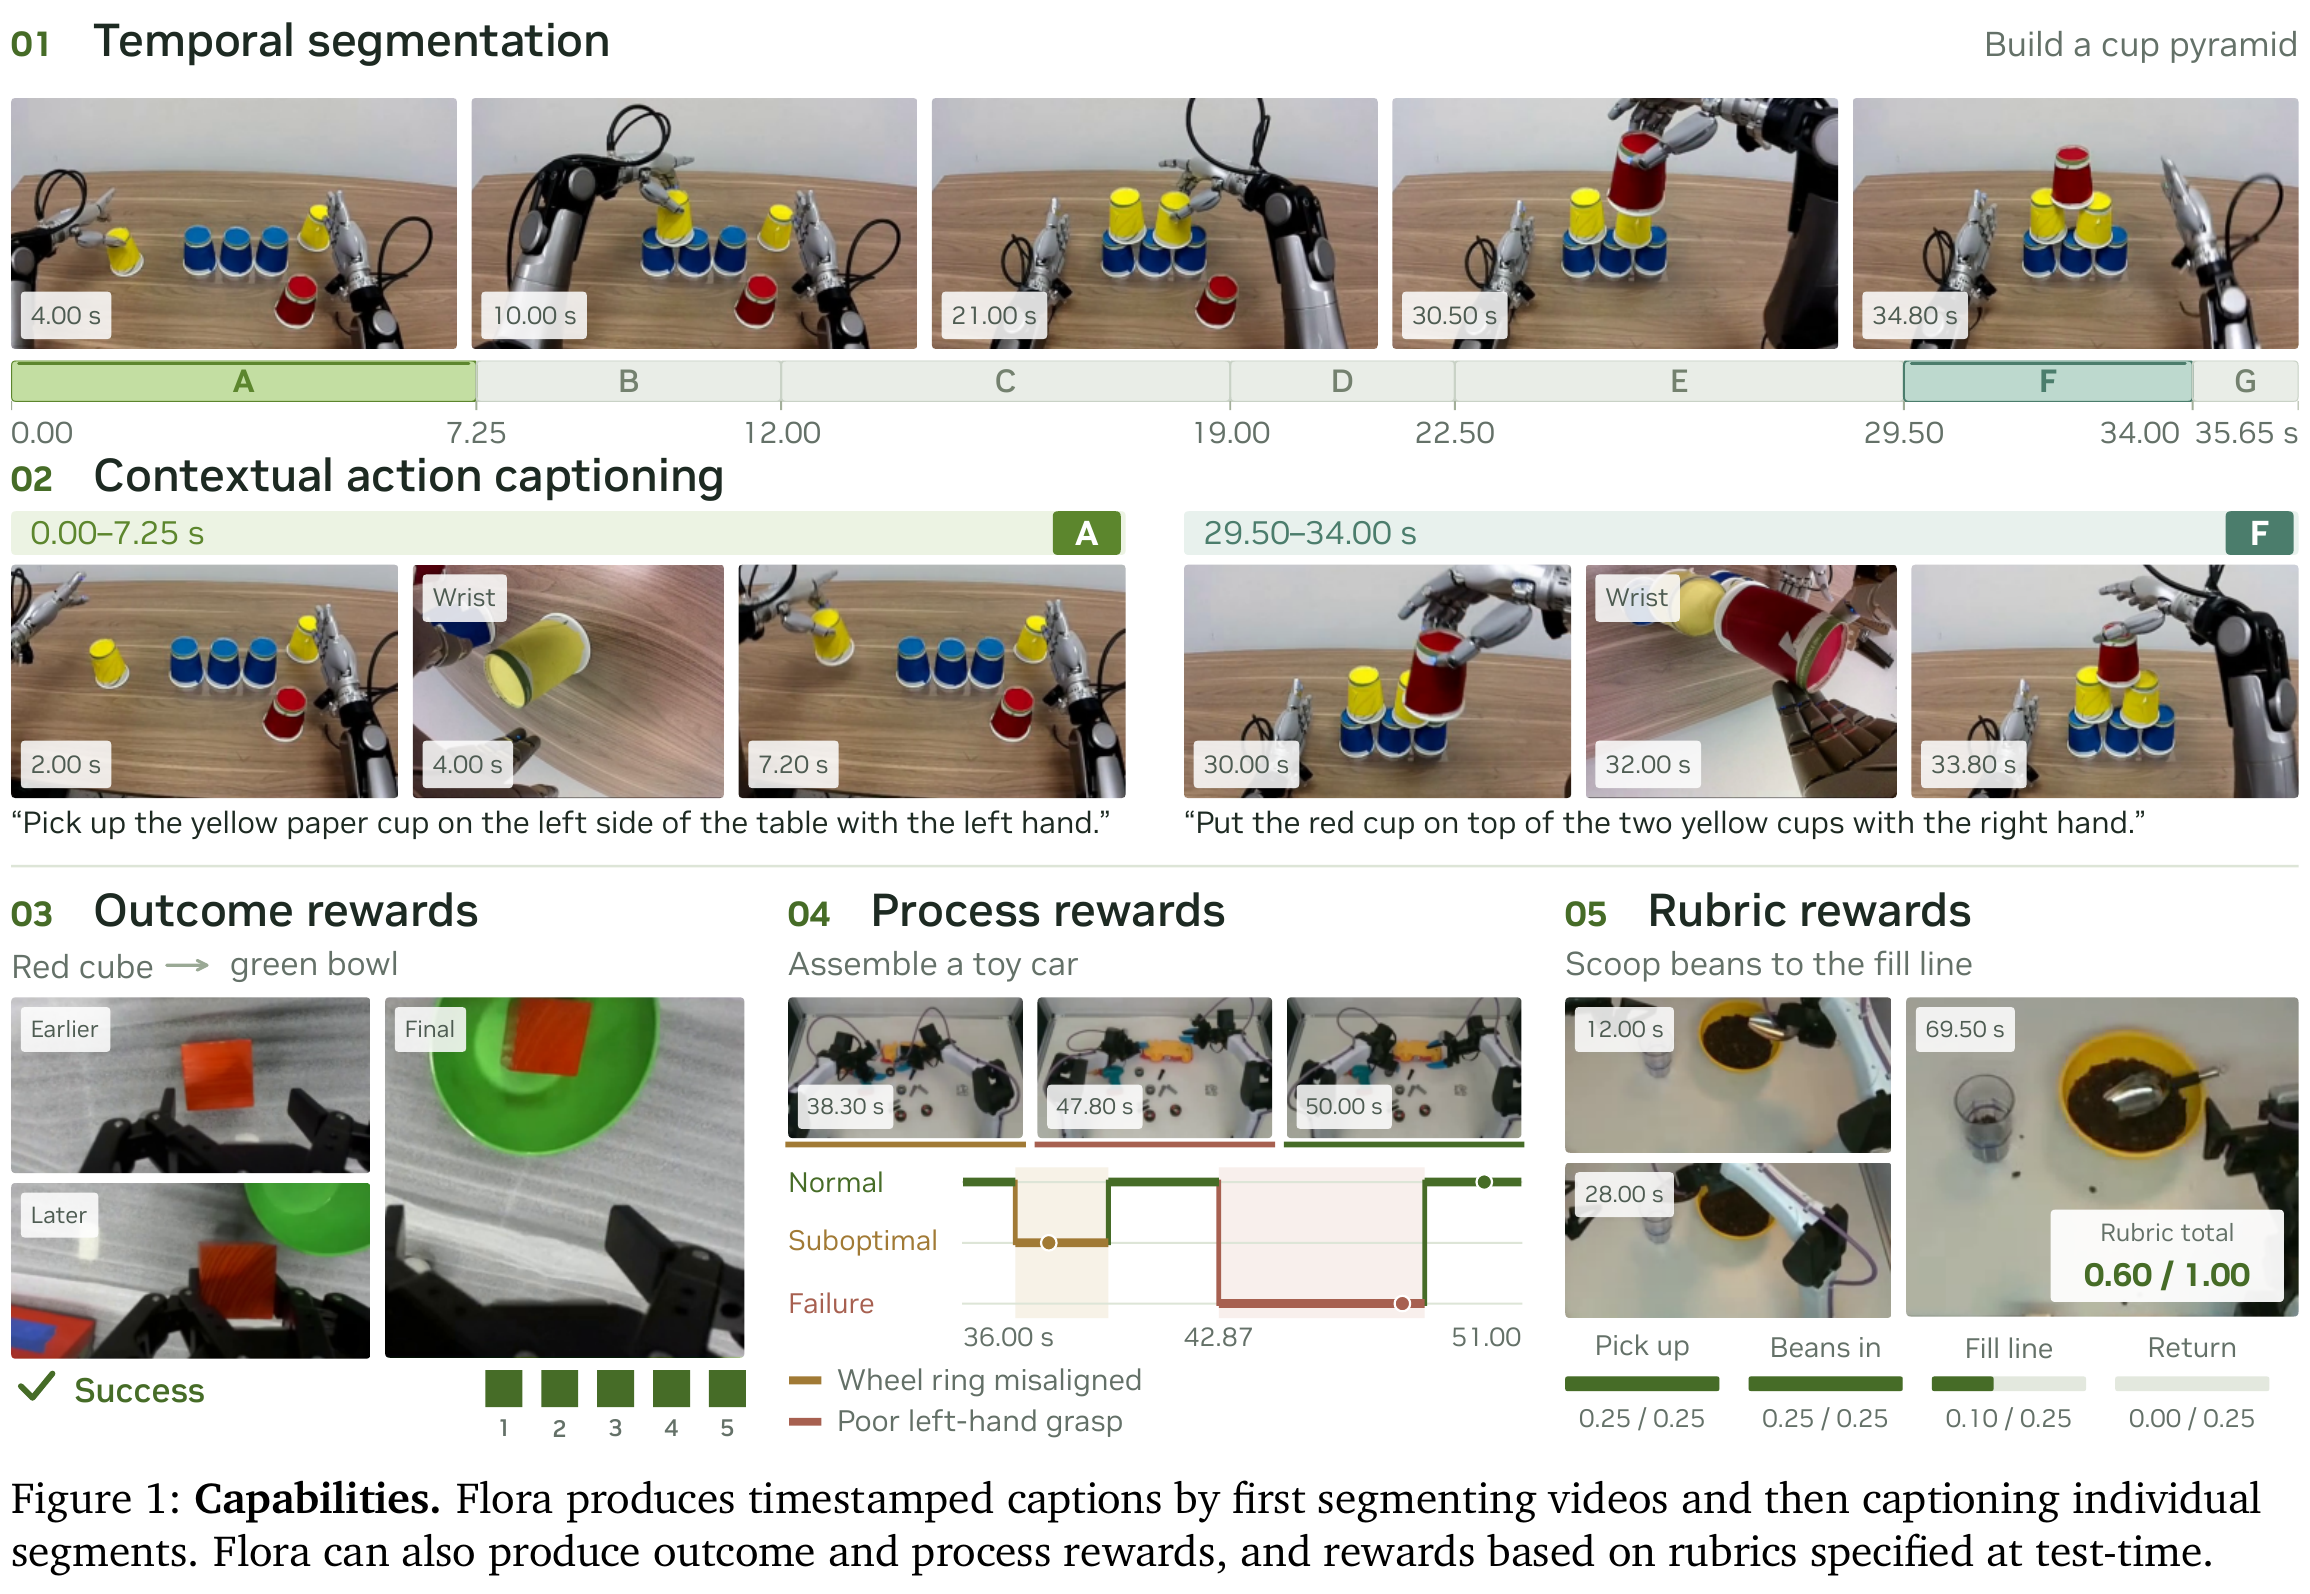
Figure 1 · 五种输出,三份模型权重

五种输出,三份模型权重
论文原图 · Figure 1 · p.1 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 上方先给动作起止时间,再为指定区间描述意图;这两步分别由segmenter和captioner完成。
  2. 下方结果、过程、rubric由同一个rewarder通过不同prompt生成。结果成功可以与中间低效或失败同时成立。
  3. 叠杯子例子中的时间段是数据标签,不是模型给机器人规划的动作chunk。
模型输入→输出训练与冻结
Segmenter:Qwen3.5-9B视频滑窗→起止时间+跨窗继续标志SFT+GRPO;rank32、α64的语言attention/MLP LoRA;视觉冻结
Captioner:Qwen3.5-27B固定区间及其前后视觉→动作描述SFT更新LM和visual merger;RL更新LM,视觉encoder/merger冻结
Rewarder:Qwen3.5-27B视频+任务+prompt/rubric→三种评分接口公开checkpoint只做SFT;更新LM、merger和视觉encoder,后者更低学习率

02 · 主干图:从一条episode走到结构化标签

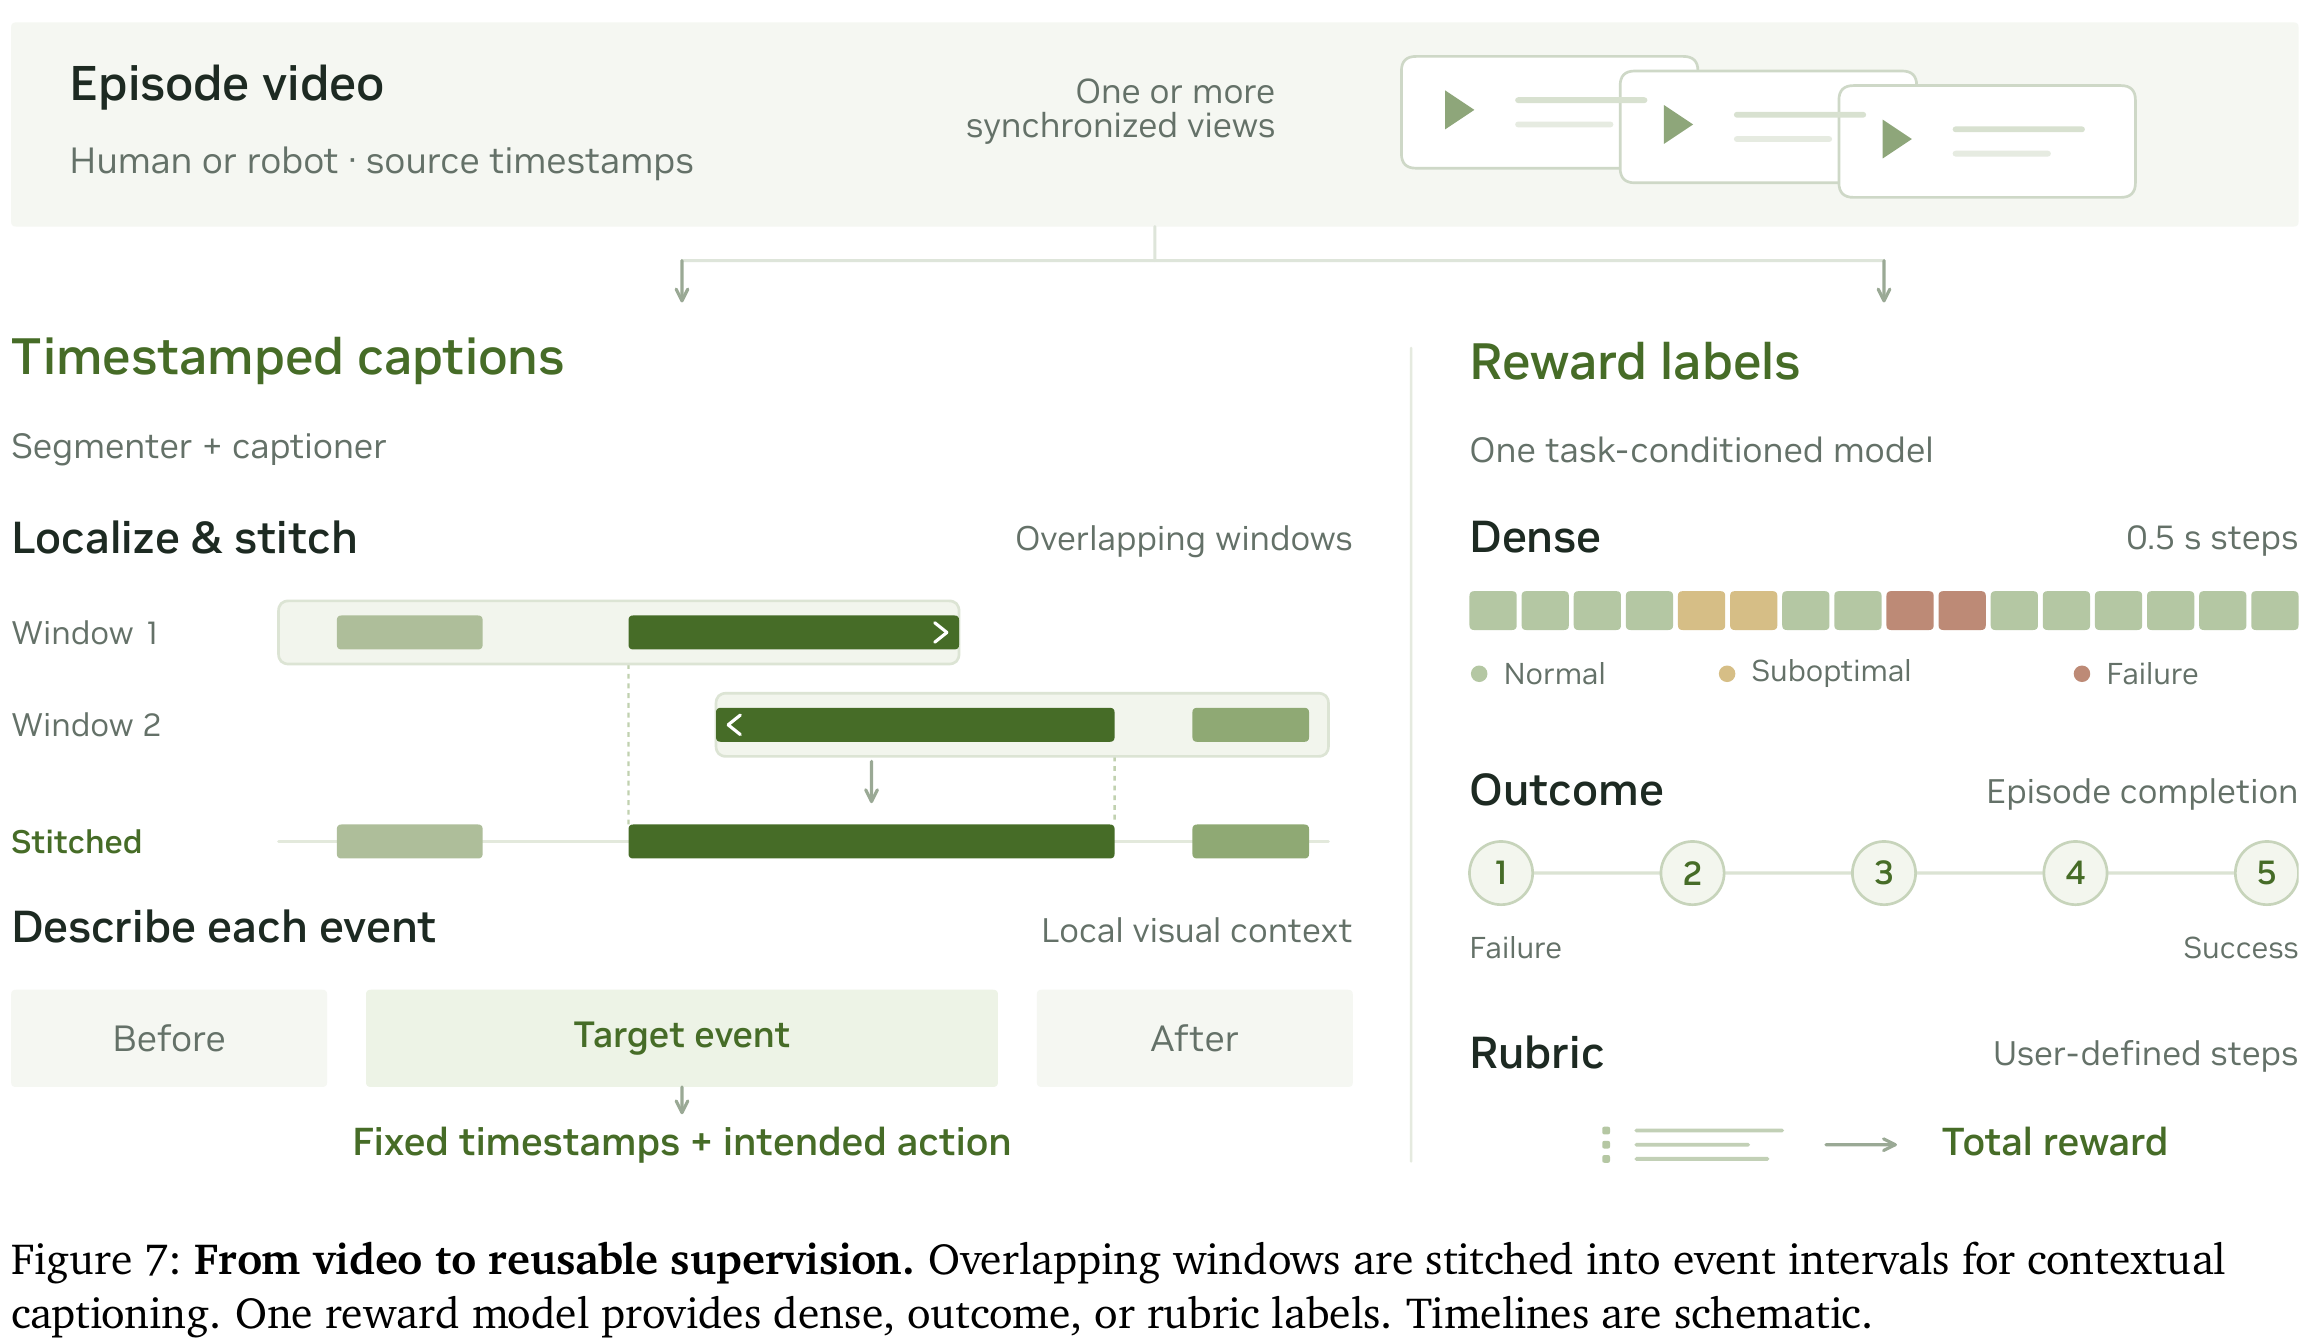
Figure 7 · 主干流程:一个视频,两类监督产品

主干流程:一个视频,两类监督产品
论文原图 · Figure 7 · p.8 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 左路滑窗分段→拼接→before/target/after描述,输出固定时间戳+动作意图。
  2. 右路奖励模型独立看视频和任务指令,按prompt生成dense、outcome或rubric。
  3. 右路不依赖左路预测的子任务caption作为真值,避免把分段错误直接变成奖励真值。
  1. 统一时钟:保留原始帧时间戳;多机位在同一源时刻形成mosaic,镜头角色固定。时间戳一致并不能单独证明硬件确实同步。
  2. 局部分段:普通窗口16秒、64帧、4Hz;中央12秒是输出core,前后各2秒是上下文guard。长程机器人数据用32秒窗、24秒core、4秒guards。
  3. 拼接与边界细化:把局部时间转到episode时间;只用core内事件,依时间重叠和继续标志拼接同一事件。有限个偏移窗口处理不确定边界,无法观察到的转折不凭空补出来。
  4. 固定区间后描述:为每个target找最近的不重叠前/后事件,分别采样视觉块,生成当前区间的intended action。描述不再改变时间边界;多个动作可以并发。
  5. 独立评分:rewarder看视频和全局任务,输出整个结果、每0.5秒过程质量,或rubric各步分数。用于数据过滤、分析和后续训练时,必须保留各标签的语义。

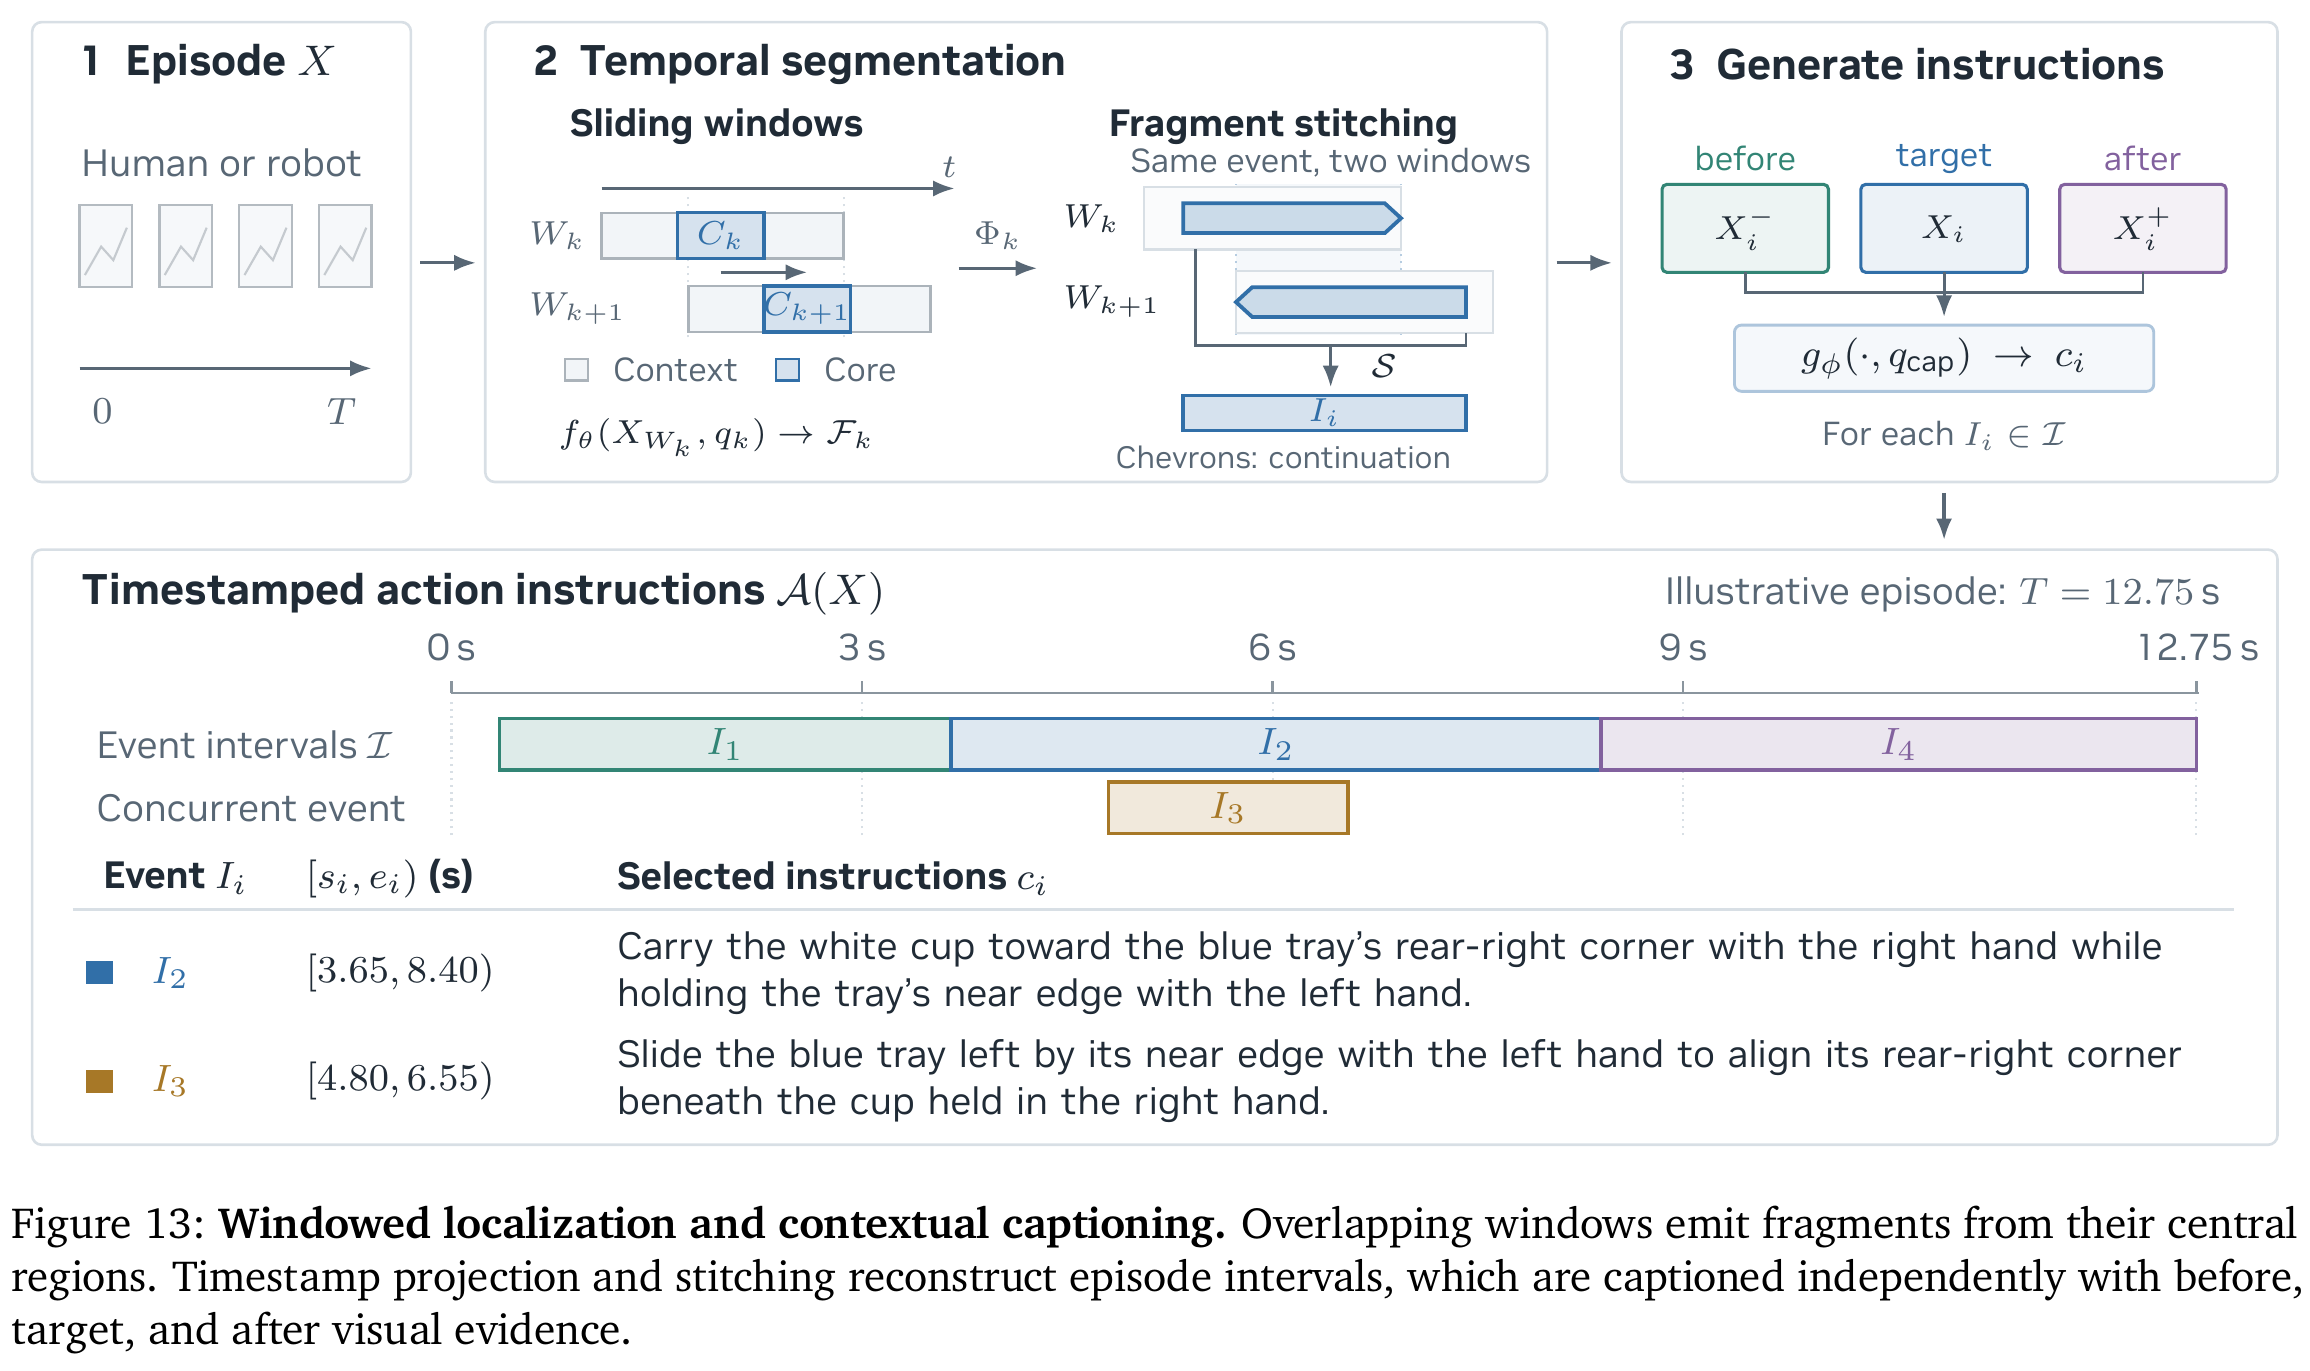
Figure 13 · 附录分段拼接图

附录分段拼接图
论文原图 · Figure 13 · p.31 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 每窗只从中央core发射事件,guard提供上下文;跨窗同一事件用继续标志和重叠关联,投影到episode时钟。
  2. I2与I3可以并发:双手一边持杯一边移动托盘,不能强制所有事件互斥铺满时间。
  3. 描述的时间戳已经固定,captioner不得重写边界。

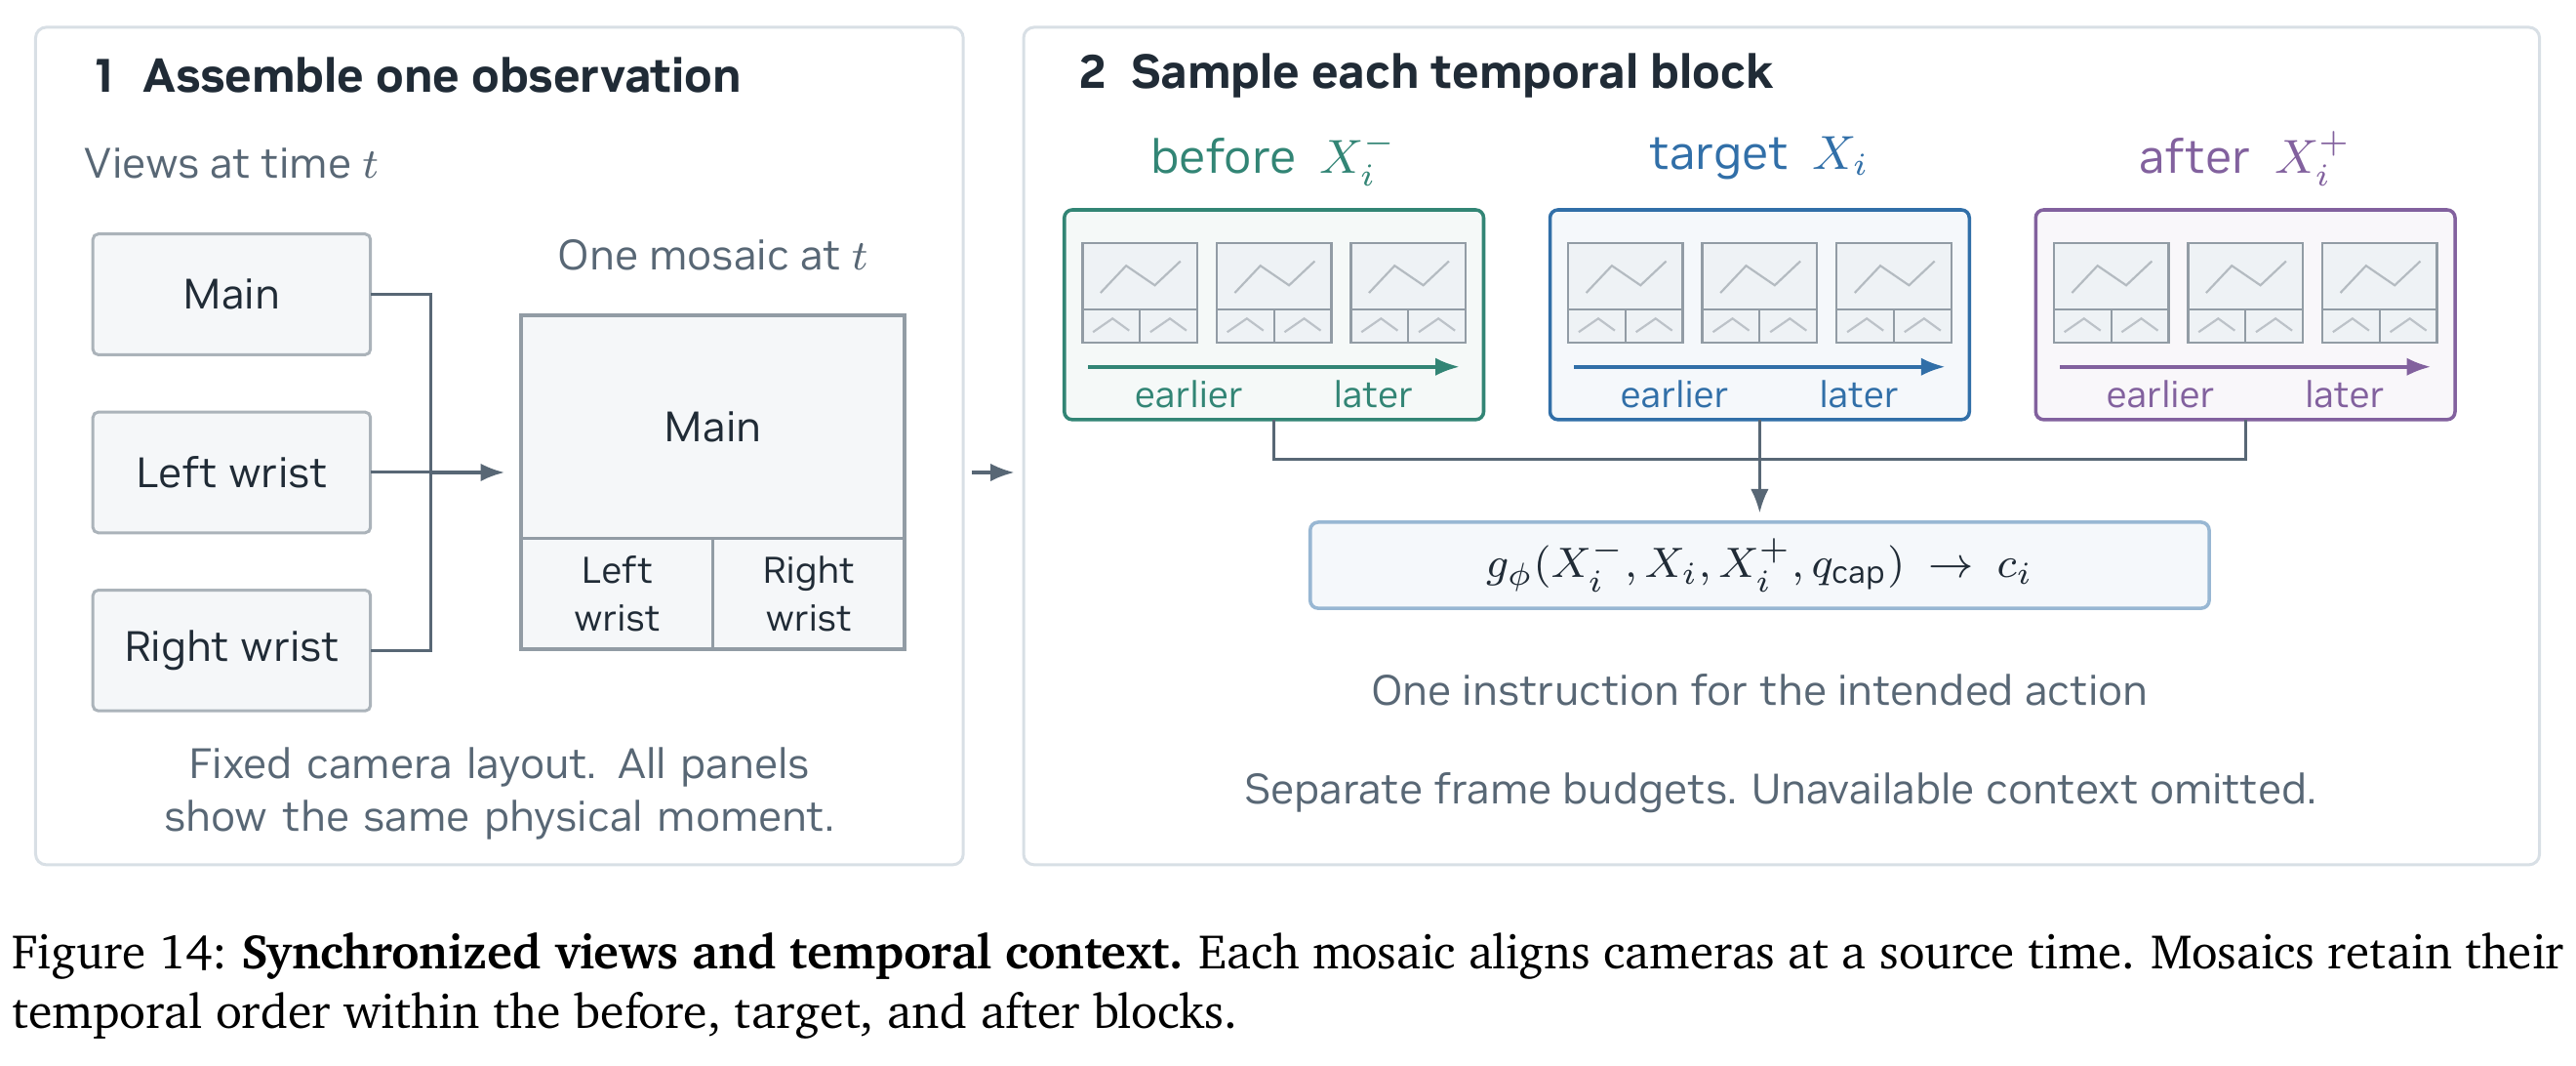
Figure 14 · 多视角与时间上下文怎样组合

多视角与时间上下文怎样组合
论文原图 · Figure 14 · p.31 · 400 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 同一时刻main/left wrist/right wrist固定位置合成mosaic,再在时间上采样before/target/after。
  2. 每块有独立frame预算,缺少相邻事件就省略;这不同于把未来动作真值塞进caption输入。
  3. 生产使用相邻事件上下文,DenseCaptionBench额外限制前后最多2秒,评测与生产设置要区分。

Eq.1、2、12–14:时间定位与描述接口

A(X)={(sᵢ,eᵢ,cᵢ)};Iᵢ=[sᵢ,eᵢ),0≤sᵢ<eᵢ≤T
Fₖ=fθ(XWₖ,qₖ)={(uₖⱼ,vₖⱼ,ℓₖⱼ,rₖⱼ)}
I=S({(Wₖ,Φₖ(Fₖ))})
jᵢ⁻∈argmaxeⱼ≤sᵢeⱼ;jᵢ⁺∈argminsⱼ≥eᵢsⱼ
cᵢ=gφ(Xᵢ⁻,Xᵢ,Xᵢ⁺,qcap)

X / T
整段视频及其时长。X的下标指定取哪一段视觉,不是机器人状态向量。
sᵢ,eᵢ,cᵢ
episode坐标的起点、终点、动作描述;半开区间避免相邻终点重复计算。
Wₖ / u,v
第k个窗口;u/v是该窗口内局部起止时刻。Φ把局部时刻投影到全局时间。
ℓ / r
左/右继续标志,表示动作是否越过窗口边缘;这里ℓ是flag,后文任务指令ℓ是不同语境。
S / θ / φ
确定性拼接过程;θ和φ分别是分段、描述网络参数。
X⁻ / X / X⁺
最近不重叠事件的before、target、after视觉块。并列候选优先短事件;没有邻居就省略。
教学算例:窗口从10秒开始,局部事件[2,5)投影成[12,15)。下一窗若继续观察同一事件,先检查重叠和flag再合并;若两只手同时做不同事,保留两段重叠事件,不能只按时间重叠一律合并。

“意图”不保证成功:手伸向杯子但抓空,动作描述仍可以是尝试抓杯子,过程标签则是抓握失败。这个分工让训练者既能按技能组织数据,又能按执行质量筛选。
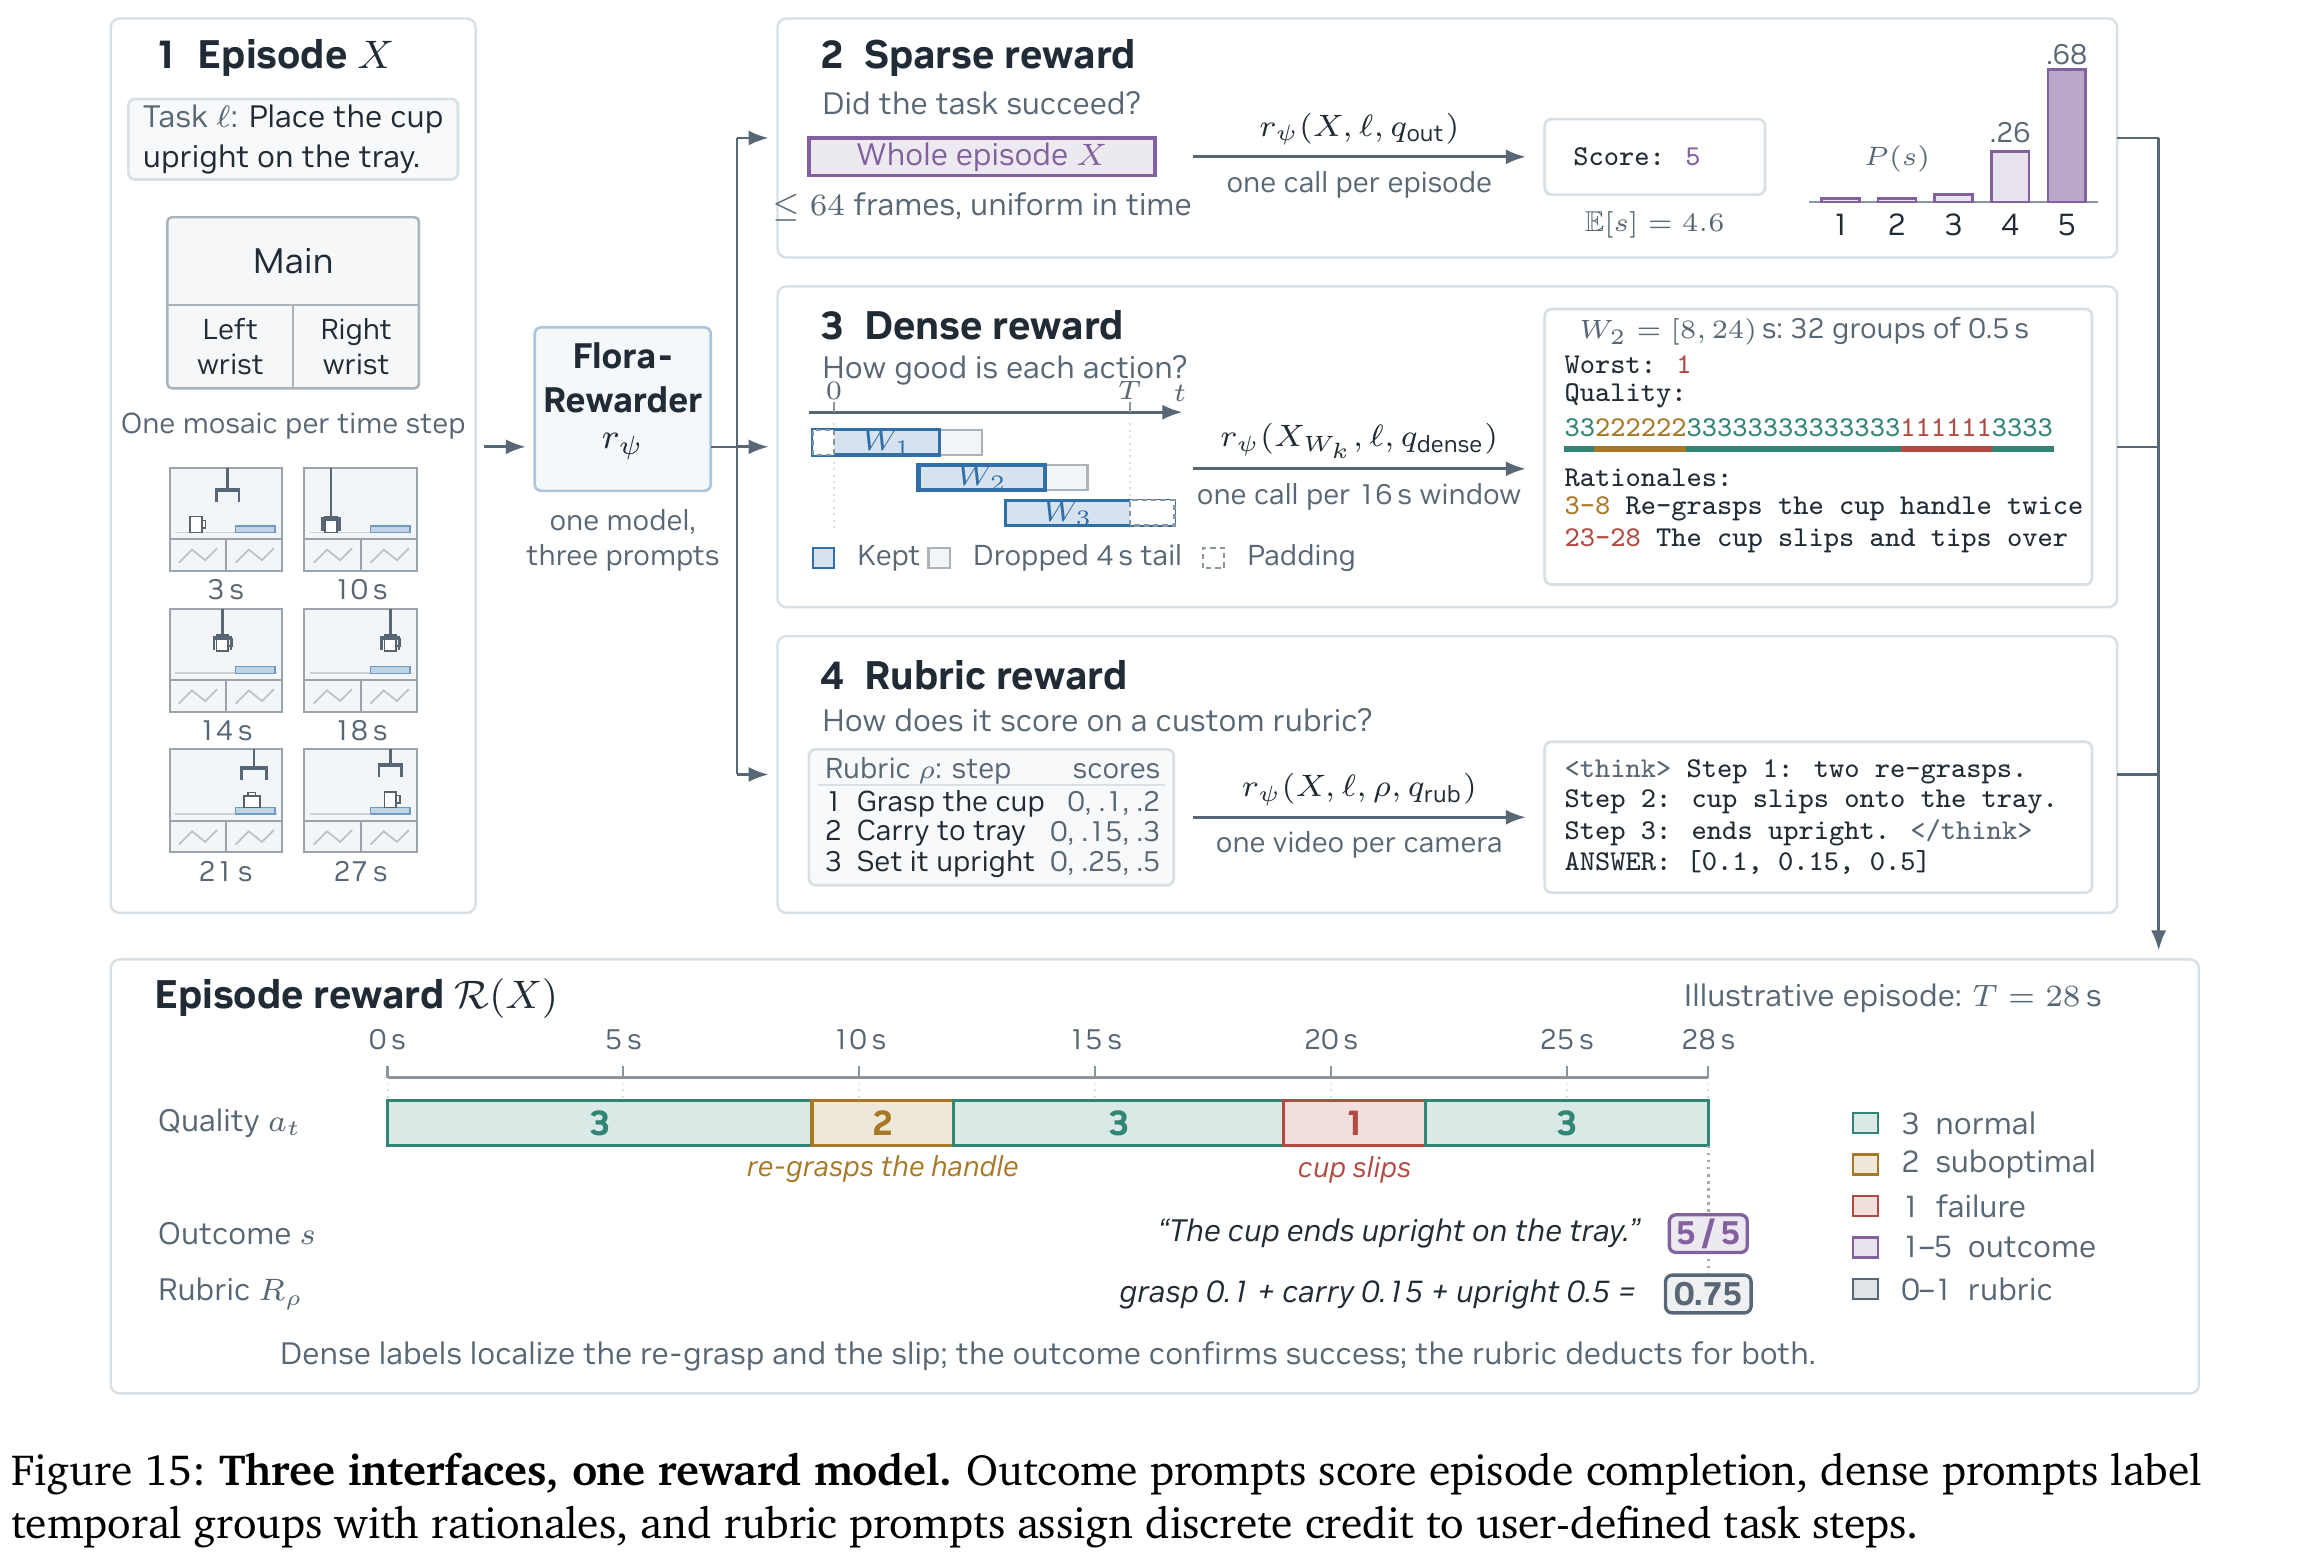
03 · 三种reward为什么可以给出不同结论?

Figure 15 · 一个最终成功仍可以有过程失败

一个最终成功仍可以有过程失败
论文原图 · Figure 15 · p.36 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 图中杯子最后直立,outcome5/5;过程中反复抓握和滑落会在dense时间轴扣分。
  2. rubric分别评抓、搬、放直,0.1+0.15+0.5=0.75;这是用户定义步骤评分,不等于结果概率。
  3. sparse outcome用完整视频,dense用有后文的16秒窗口,rubric多视频+指定评分层级。

Eq.3、18–21:结果、过程和rubric接口

R(X)=({aₜ},s),aₜ∈{1,2,3},s∈{1,…,5}
pₖ=pψ(s=k|X,ℓ,qout);E[s]=Σₖ₌₁⁵ k·pₖ;ŷ=(E[s]−1)/4
rψ(XWₖ,ℓ,qdense)=(wₖ,(aₖ,₁,…,aₖ,₃₂),{(uₖⱼ,vₖⱼ,cₖⱼ)}),wₖ=mingaₖ,g
ŷrub∈V₁×…×Vₙ;Rρ(X)=Σⱼŷⱼ;L₁(ŷ,y)=Σⱼ|ŷⱼ−yⱼ|

ψ / ℓ / q
奖励网络参数、全局任务指令、不同接口prompt。dense不输入泄露成败的子任务文字。
aₜ
1失败、2次优、3正常;不是机器人action vector。0.5秒一组对应4Hz的两帧。
s / pₖ / ŷ
结果1–5分;score token的归一化概率;期望分线性映到0–1。RoboRewardBench用生成整数,轨迹排序使用期望。
wₖ
32组里的最坏质量;只约束结构化答案一致性,不将整窗每一组都改成最坏标签。
ρ / Vⱼ
用户rubric与第j步允许的离散分值。各步最高分加起来1,模型须从允许层级选择。
教学算例:结果分布p₄=0.2、p₅=0.8,E[s]=4.8,ŷ=0.95。一次搬杯子若先抓滑、最后放直,可结果5/5;dense保留滑落失败;rubric抓取0.1+搬运0.15+放直0.5=0.75。三者问的问题不同,数值不必一致。

Outcome最多均匀取64帧,约10Hz候选采样后限制预算,覆盖首尾;score-only最多12新token、有rationale最多160。提取生成score位置top20候选中1–5数字的概率再归一化,这个分布不等于已经校准的成功概率。Rubric按每机位独立视频输入,2–10步内部任务或1–4步外部任务;评测时还使用9样本medoid,不能与单次greedy成本混为一谈。

自测:最后成功,能否把整条轨迹所有过程标签都改成normal?
不能。局部失败、危险和低效是过程监督的对象。最终恢复仅改变结果,不应改写过去;反过来,后面发生无关失误也不应把之前正确动作降级。

04 · 密集奖励怎样拼接?为什么它是回看式的?

附录G给出精确窗口:锚点αₖ对应64个位置αₖ+(i−9)/4秒,i=1…64,名义范围[αₖ−2,αₖ+14)。越过episode边缘重复最近帧;两帧一组,取较严重人工标签。训练按episode划分,评测episode不出现在训练/验证。

推理锚点通常每10秒一个,末尾补一个对齐最后帧的窗口。每个非末窗保留前24组,丢最后8组=4秒;末窗保留有效组。这样多数保留标签能看见至少4秒后文,便于识别刚才的滑落究竟是不是失败。

Eq.22:多窗预测冲突时选谁?

aₜ=ak*,g*;(k*,g*)=lexmin(k,g)∈C(minτ∈τₖ,g|t−τ|,−min(g−1,32−g),k,g)

C / τₖ,g
保留的有效窗口组集合,以及一组两帧的源时间戳。
lexmin
字典序比较:先时间距离最近;再偏向离窗口边缘更远的组;再选更早的窗口和组。
aₜ
最终源帧t的质量标签。连续同标签合成片段,非normal片段取出现最多的rationale。
教学算例:t=12秒在两个窗口都有预测,先找哪组采样点最近;距离相同则选上下文更完整的窗口内部组,而非平均1和3得到2。标签是离散类别。

解析采用结构化语法,Worst与Quality不一致拒绝,解析失败替换为全normal并加flag。生产者必须保留这个flag,否则会把技术失败当成安全正常数据。回看窗口也意味着它主要适合离线标注、分析与数据筛选;若改成在线机器人安全监控,需要处理后文缺失、额外延迟和重新校准,不能原样宣称是因果实时critic。
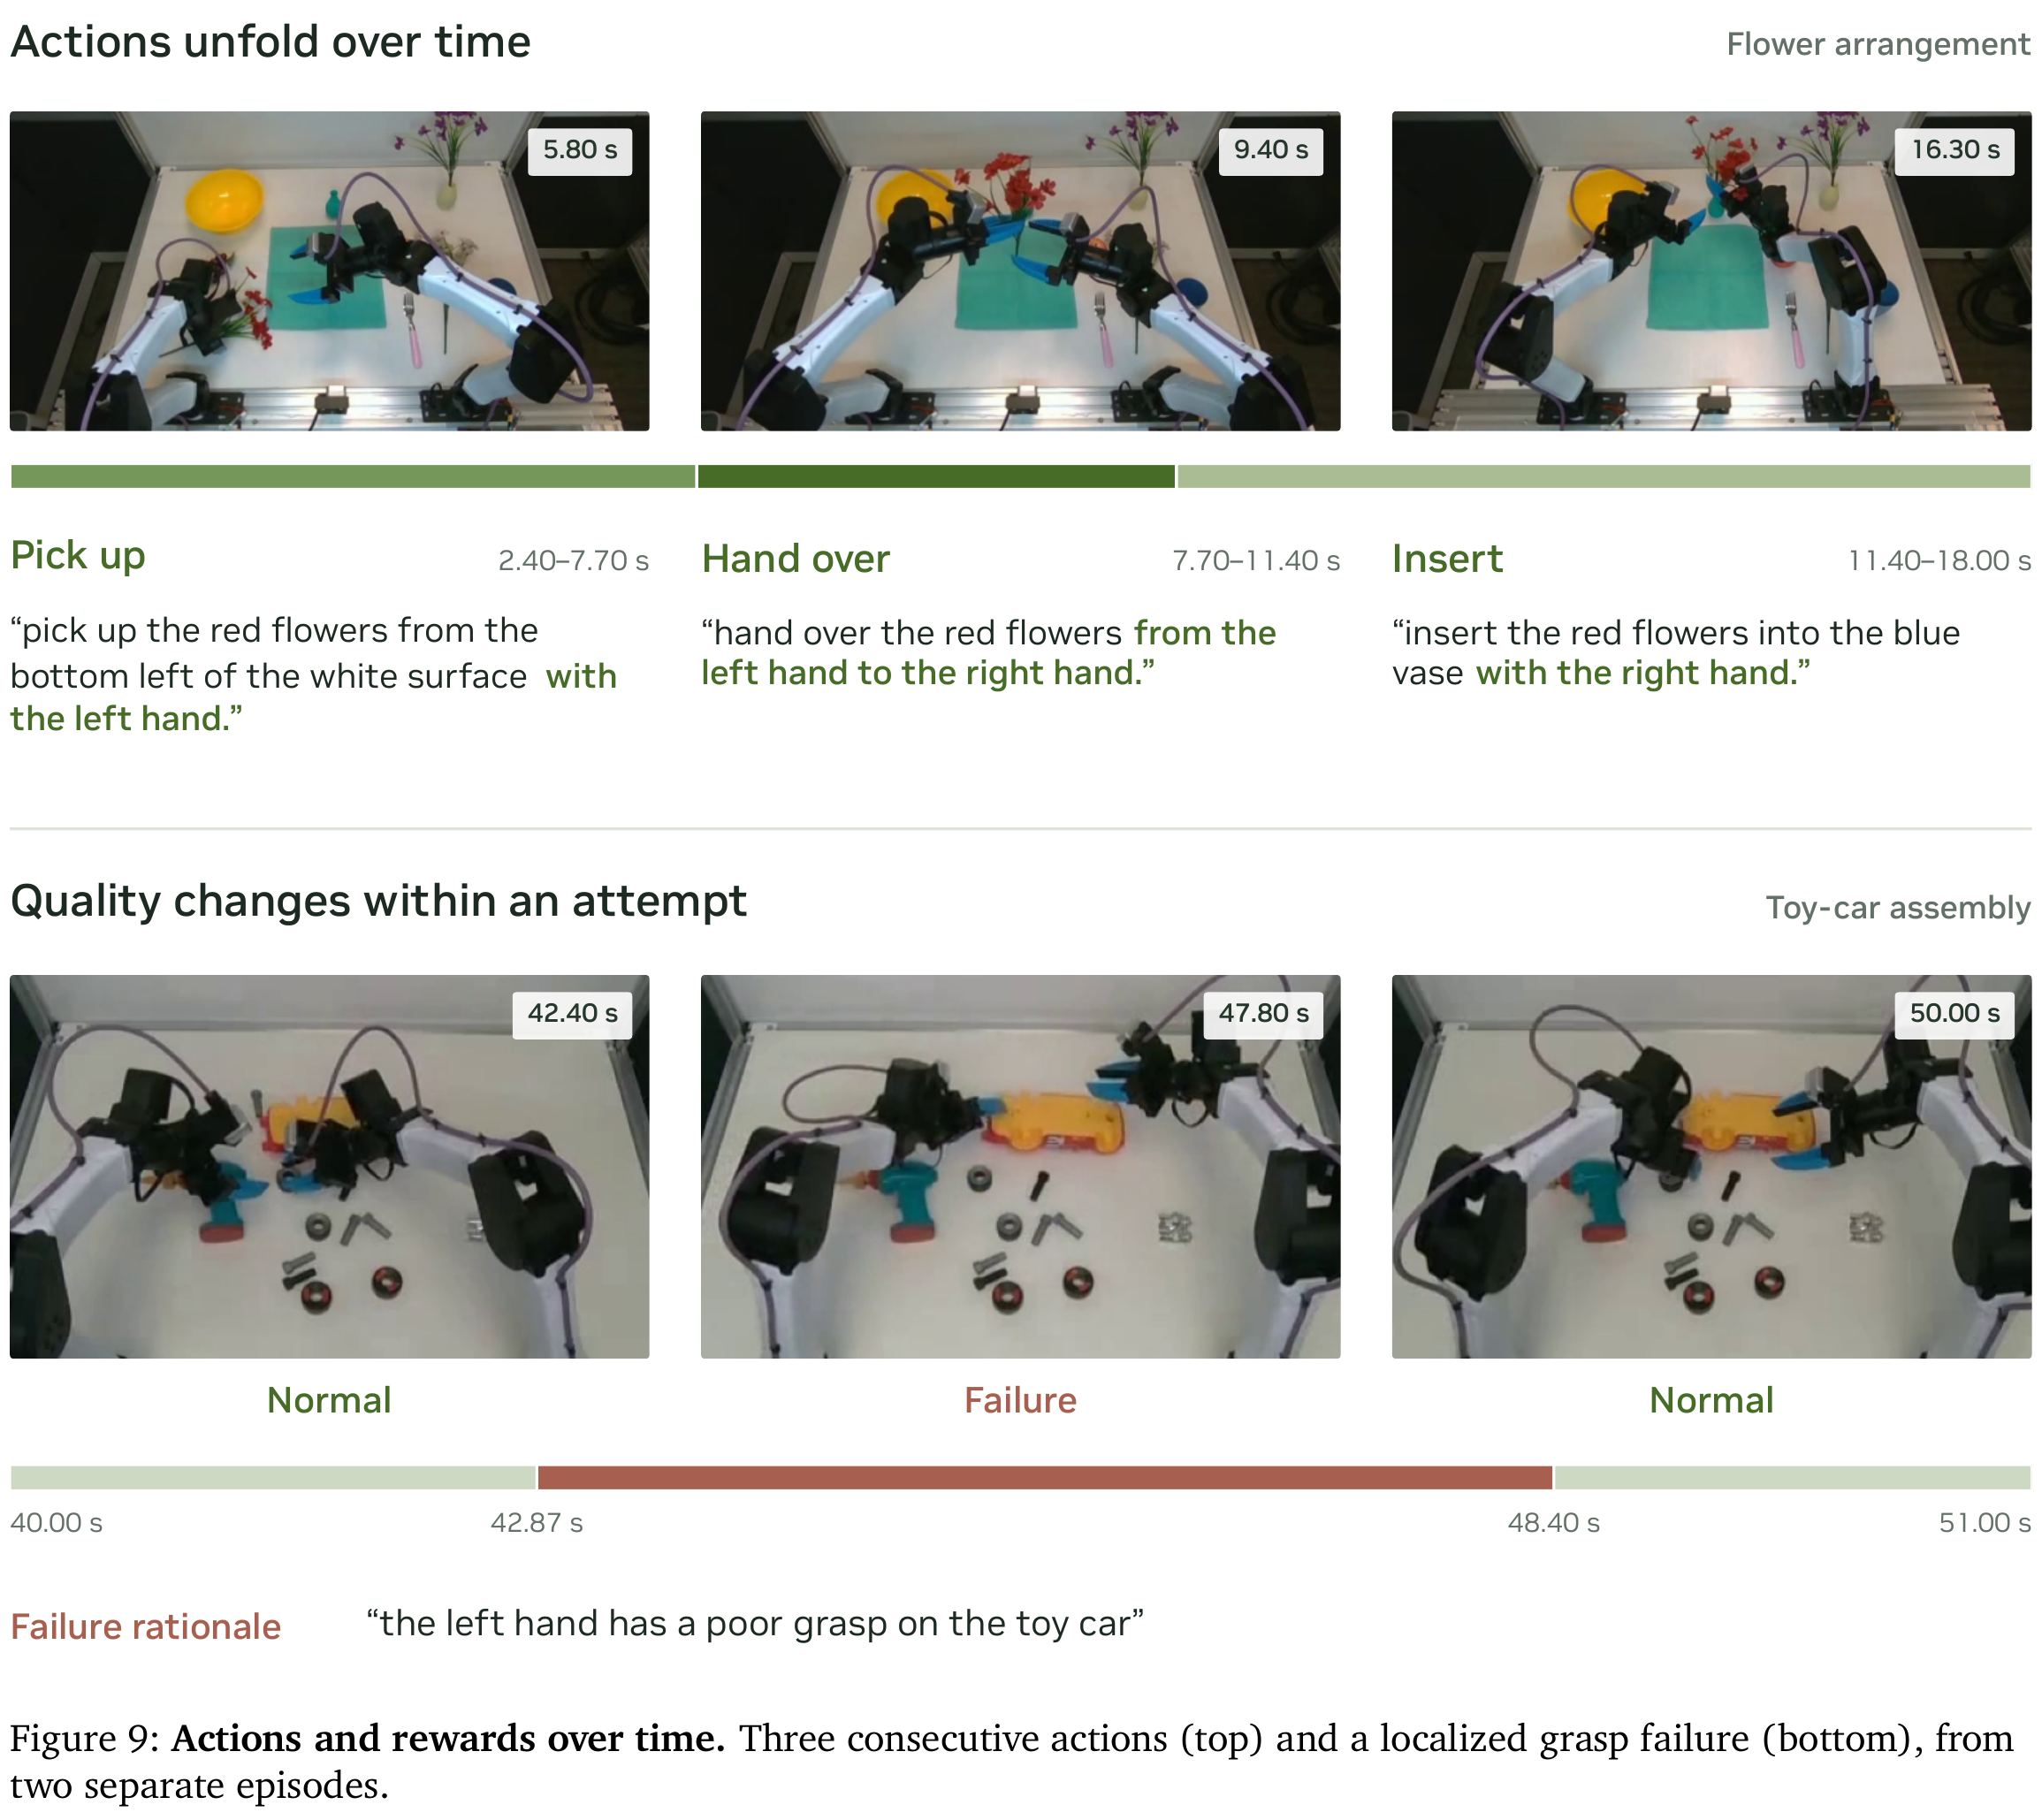
Figure 9 · 动作阶段与执行质量是两条时间轴

动作阶段与执行质量是两条时间轴
论文原图 · Figure 9 · p.25 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 上面插花依次pick/hand over/insert;下面抓玩具车的局部失败随后恢复正常。
  2. 一个动作意图可以跨多个质量阶段,失败后恢复不会改写之前的失败标签。
  3. 示例来自两条不同episode,不能读成同一串视频的完整轨迹。

05 · SFT、GRPO分别优化什么?

Eq.15:三个模型共用的SFT形式

Lη(B)=−[Σ(x,y)∈BΣt=1…|y|log pη(yₜ|x,y<ₜ)] / [Σ(x,y)∈B|y|],η∈{θ,φ,ψ}

B为batch,x为视觉与任务prompt,y为目标输出文本;|y|为输出token数。只在输出token上计算交叉熵,按整个batch输出长度归一。η依任务选择分段、描述或奖励模型参数。

教学算例:两条输出长度2/3、负log概率总和1.0/1.5,loss=(1+1.5)/(2+3)=0.5。不是先各自平均再对长短样本等权。

Eq.16:分段GRPO奖励

rseg=0.45F₀.₅+0.15F₀.₇₅+0.25P₀.₅+0.15B

Fτ与Pτ是tIoU阈值τ下、一对一匹配后的F1和precision;B是匹配对边界奖励,端点总误差d另给错误继续flag各加0.5秒,单对为max(0,1−d/1秒)。先最大匹配数量,再最小化截断误差。没匹配时B=0,双方空集合则奖励1;格式无效或截断奖励0。

教学算例:F₀.₅=.8、F₀.₇₅=.5、P₀.₅=.75、B=.9时,奖励=.36+.075+.1875+.135=.7575。权重鼓励找全动作、减少乱切、提高边界精度。

Eq.6、7、17:描述不能靠堆细节骗分

R=Σa∈Amₐ;M=Σa∈Amₐzₐ;F=1.25Σh∈Ewg(h);q=rcap=2M/(R+M+F)

A是有证据的参考要求,mₐ是质量权重,zₐ是是否覆盖;四组action/identity/coordination/detail权重.50/.25/.20/.05。E是已证实错误的语义族,同一错事实重复说只罚一次;来源不确定要求不计入R。阶段依赖要满足,不能用放下后的状态冒充伸手阶段。

教学算例:支持总量R=1,覆盖M=.75,无错误得1.5/1.75≈.857;若产生加权错误F=.25,降到1.5/2=.75。长而幻觉的caption可能比短而准确更差。

两类GRPO都在同一输入的rollout组内减去奖励均值,不做标准差归一。分段LoRA有相对固定SFT策略的KL约束;描述RL更新语言模型。checkpoint在独立验证集选,分段有各受保护组最多跌2pp限制,描述按三本体均值与无逐组退化规则选,两者独立。benchmark不用于选checkpoint。

Rewarder把outcome、dense、rubric样本混合打乱,公开模型只做SFT,没有任务族重加权。原始密集标注是人工动作区间+质量+原因,重叠取更严重类别;结果二值成功/失败映成5/1,部分完成p映成1+round(4p)。完整训练数据规模、来源比例和最优混合比未报告。

06 · 评测公式:F1、语义质量和联合分数怎样算?

Eq.4、5、8:选数据和算分是两件事

Φ(S)=Σg∈G(1/|Tg|)Σt∈Tg√(nₜ(S)/Nₜ)
Fseg=2TP/(|Î|+|I*|)
Fjoint=2·maxMΣ(i,j)∈Mqᵢⱼ / (|Î|+|I*|)

Φ / S / g / t
覆盖选样目标、所选episode集合、元数据组、组中标签;Nₜ是候选池带标签t的episode数,nₜ是已选数量。平方根让重复覆盖边际收益变小。未用模型分数挑测试样例。
Î / I* / TP
预测区间、参考区间、tIoU达阈值后的最大数量一对一匹配数。
M / qᵢⱼ
时间合格边上的一对一分配与该caption的质量。联合匹配最大化质量和,空caption仍保留在分母。
教学算例:3段预测、2段参考、匹配2对:分段F1=4/5=.8。两对语义质量.8/.5,联合F1=2×1.3/5=.52。不能把“平均分段F1×平均caption分”当联合F1。

DenseCaptionBench用tIoU≥.5,整数微秒边界,不吸附参考边缘;WGO用≥.75且按公开协议吸附首尾外边缘。WGO字幕接受与Dense的点质量又不同,所以两套F1不能直接按数字大小比较。

Dense参考含4,877段:Human3,220、夹爪1,266、灵巧手391。机器人参考中1,364是已确定意图,293是观察操作proxy;来源不确定性保留。Astra还同时充当Dense caption judge,存在generator–judge自偏好风险;固定参考与采样视觉也限制裁判精度。
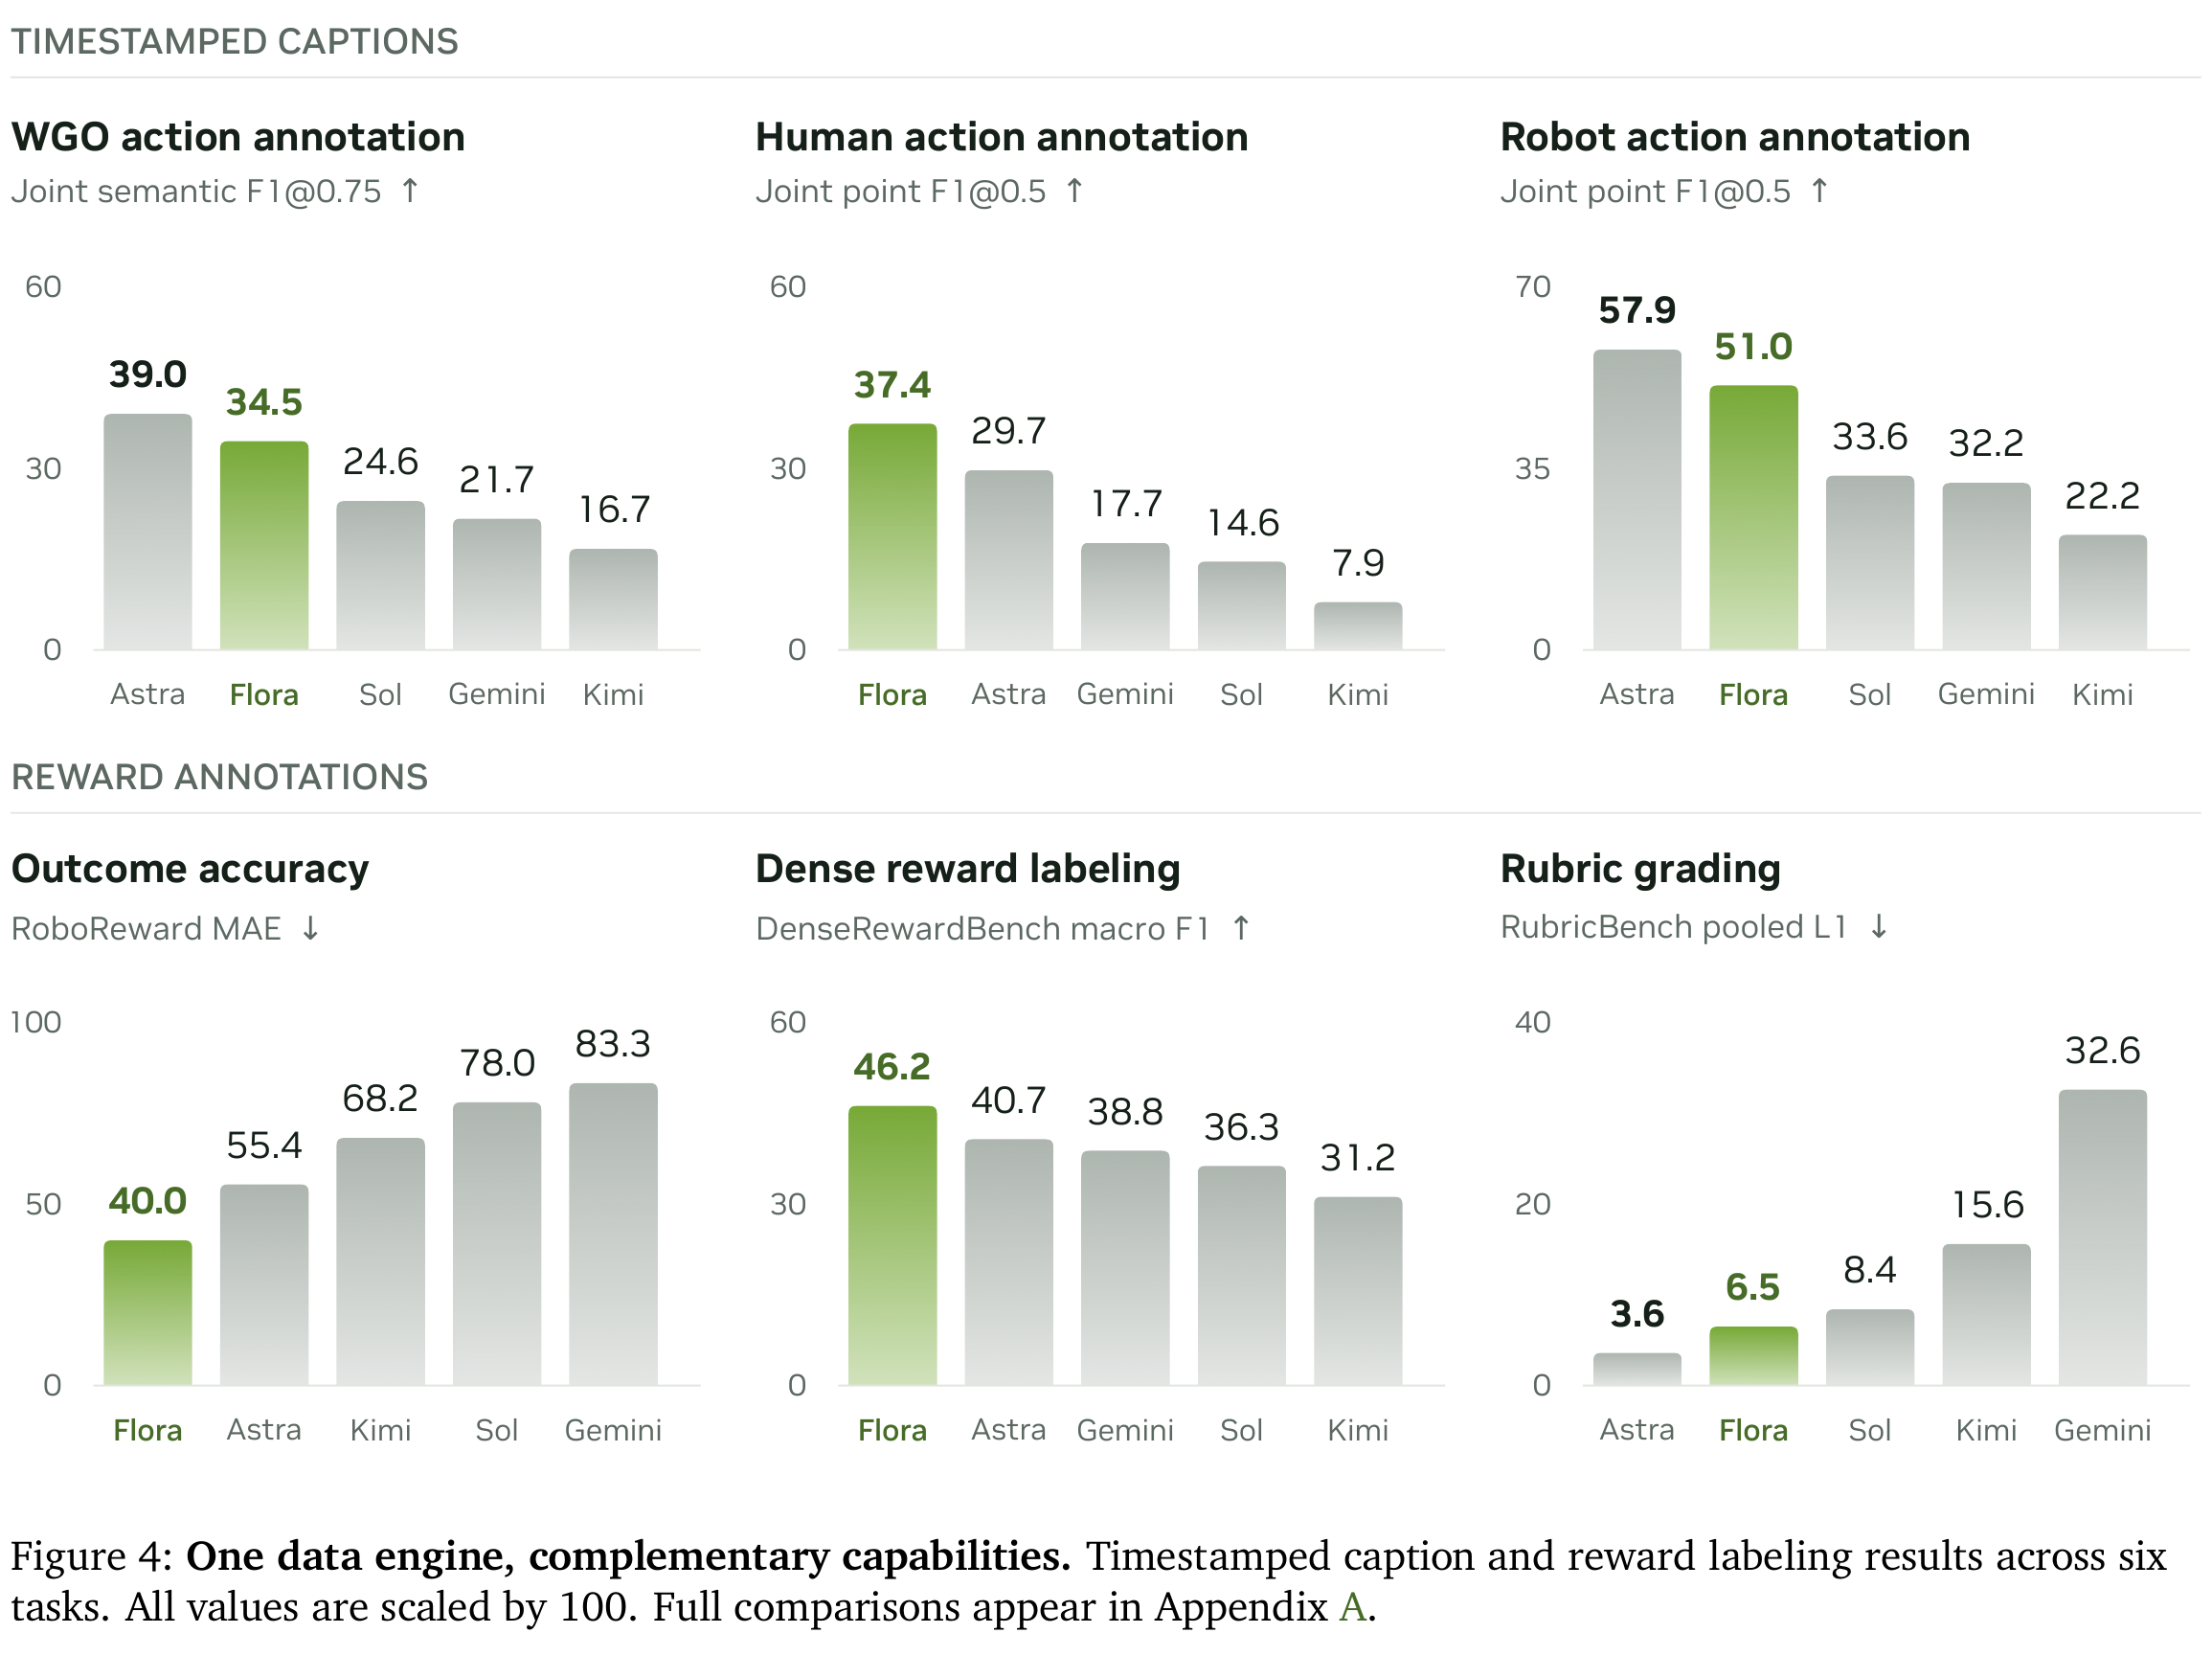
07 · 结果表:哪些地方强,哪些地方仍会失败?

Figure 4 · 不同能力没有一个通用冠军

不同能力没有一个通用冠军
论文原图 · Figure 4 · p.4 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 六面板分别测时序语义、机器人/人类描述、结果、过程和rubric;横纵指标不可合并排名。
  2. FLORA在人类联合描述与密集奖励领先所列模型,但WGO联合34.5低于Astra39.0,Robot51.0低于57.9。
  3. MAE、L1越低越好,F1越高越好;图中都乘100不代表它们都是百分比成功率。

仿真 / policy证据

项目论文报告能支持的结论
LIBERO、RoboTwin等闭环仿真未报告FLORA驱动policy的SR标签工具评估不等于控制评估
使用FLORA训练GR00T作者报告生产使用缺少相同policy和数据量的标签前后闭环消融,不能归因SR增益

ID/OOD及跨本体标注

评测 / 样本 / 协议FLORA参照与边界
WGO100:25HomER/50DROID/25Galaxea;tIoU.75;三个子集等权分段50.3;gold描述64.7;联合34.5Astra46.0/77.4/39.0;分段领先,联合不领先;不是100条直接池化均值
Dense Human100;tIoU.5分段54.6;描述66.5;联合37.4Astra44.2/60.3/29.7;本文范围内人类细动作有收益
Dense Robot200;夹爪/灵巧手各100,双组等权66.9 / 73.7 / 51.0Astra71.9 / 80.2 / 57.9;FLORA并非全面更优
Dense夹爪 / 灵巧手联合52.6 / 49.4输入、粒度与参考类型不同,不归因于本体单一因素
Robometer:567 OOD轨迹排序;τₐ0.720Astra0.823更高;专用模型保留原文协议,部分样本数不同
Robometer:成功轨迹255ID / 105OOD;VOC0.989 / 0.996与时间线性增长也可高分,不能当失败检测召回;Astra.989/.997

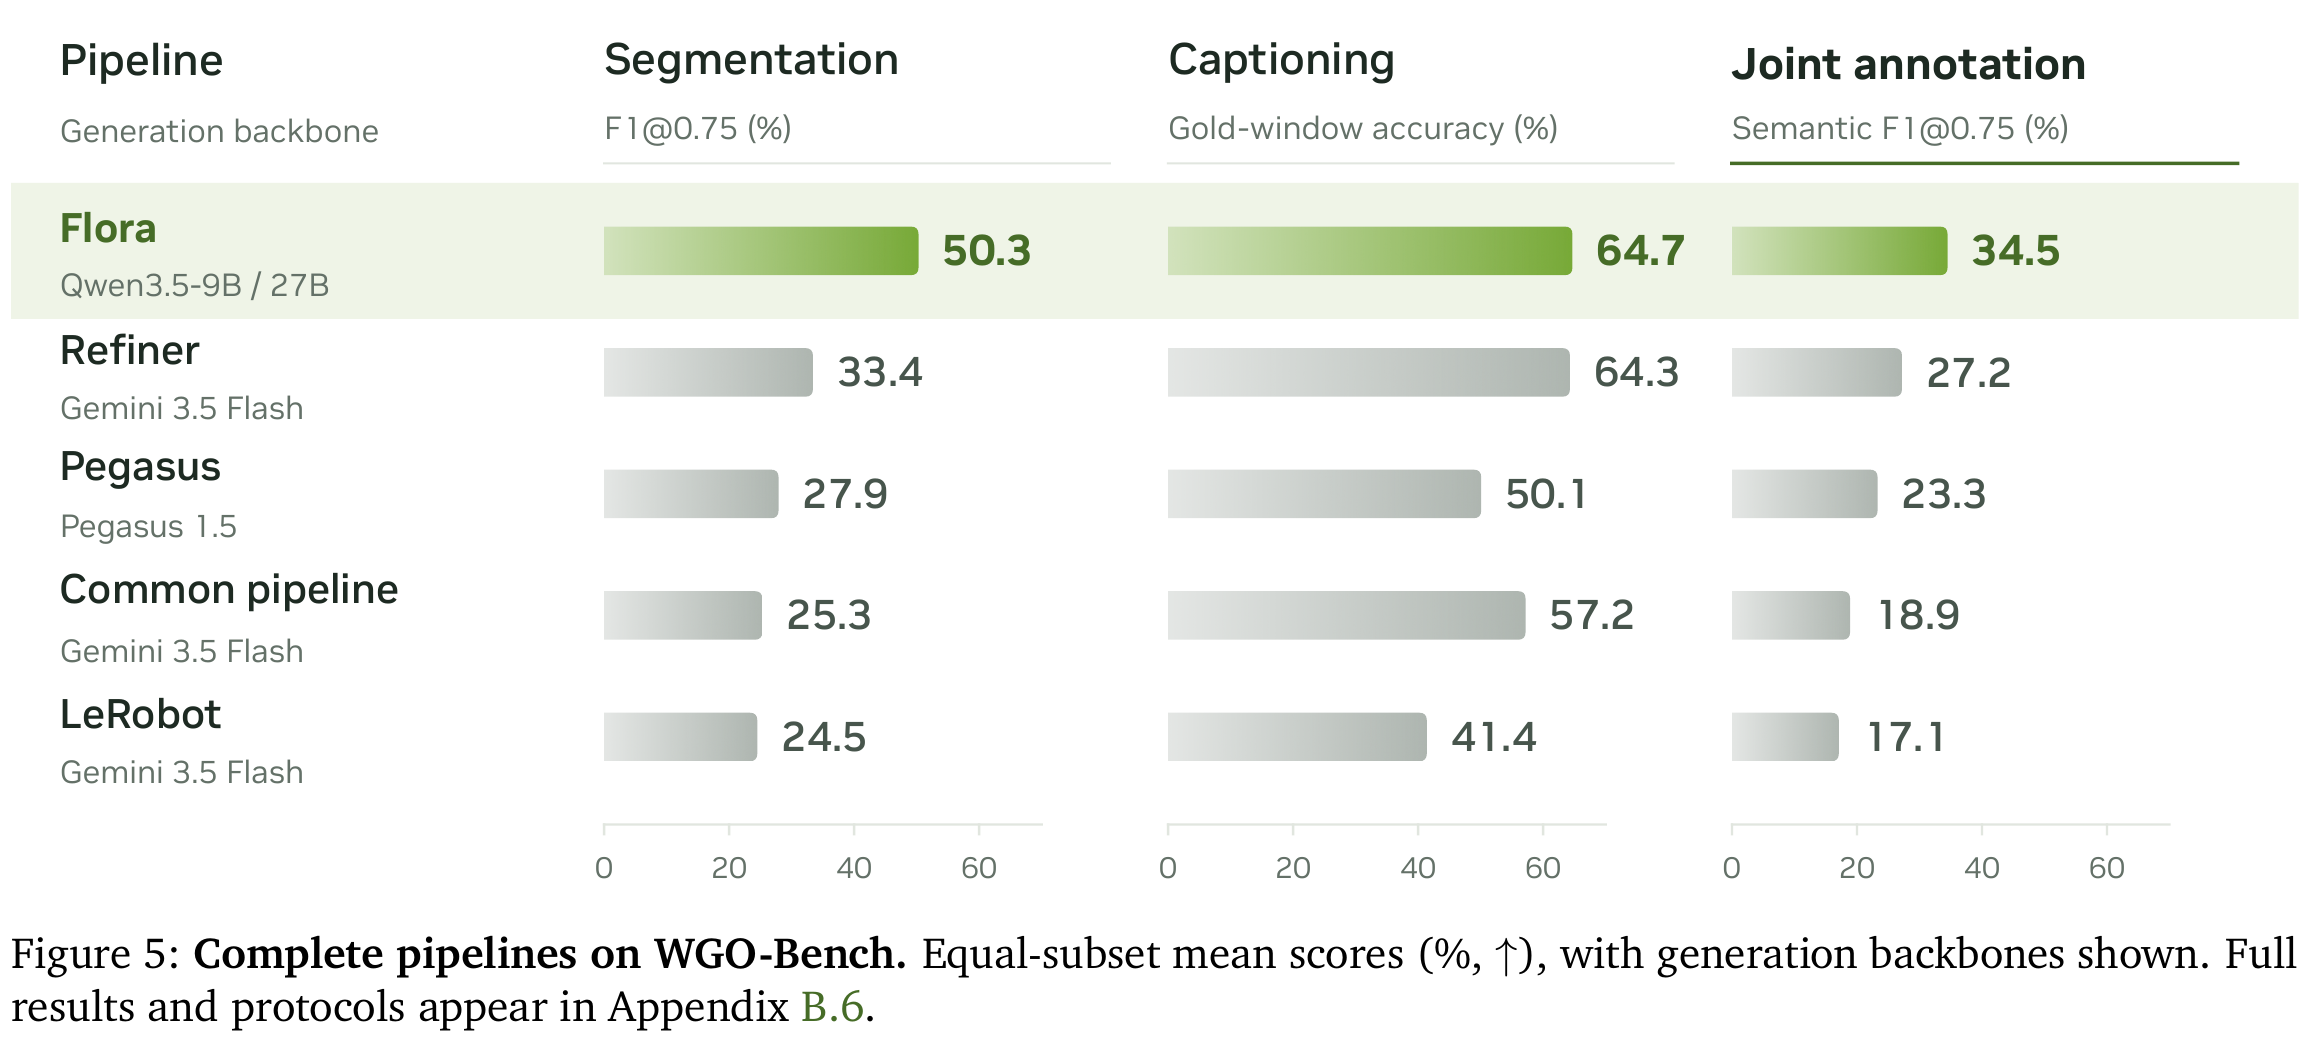
Figure 5 · 完整流水线比较的收益在哪里

完整流水线比较的收益在哪里
论文原图 · Figure 5 · p.5 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 相对Gemini3.5 Refiner,分段50.3对33.4,而gold-window描述64.7对64.3接近;主要优势来自时间定位。
  2. 不同系统有不同backbone与输入流程;附录换到Gemini3.8后Refiner联合36.4超过FLORA34.5。
  3. 这是整体系统比较,不能把16.9pp分段提升全归因于某一个训练技巧。

附录B.6换backbone后,Refiner+Gemini3.8的WGO分段42.0、描述73.8、联合36.4,联合超过FLORA34.5。直接把FLORA模型替换为API而保留生产窗口/拼接,仅19.4/52.1/11.1(Gemini3.5),说明训练模型与流程协同重要,也说明“流程本身一定更好”没有被单独证明。

真机记录上的奖励评价(不是部署成功率)

数据 / 指标FLORA / 比较协议与误差
RoboReward,2831episode;1–5分MAE0.400 / Astra0.554原表乘100显示40.0/55.4;不能读成40%失败率
DenseReward,40held-out双臂episode;4861个1Hz步骤MacroF1 .462;balanced acc .542;bad-actionF1 .477;failure recall .5333942normal/619次优/300失败;约11%normal误判失败。基线最高失败召回.117,Astra为0
RubricBench,40episode/10任务,任务名与episode均留出;pooledL1.065 / Astra.036FLORA9样本medoid,基线多数1样本;采样/帧数/推理预算不同
前向实时监控 / 自动RL后训练闭环本文未报告同协议成功率或安全事件改善回看标签可以辅助此类系统,仍需另行验证

缺失请求采用固定分母、无operational credit;Dense机器人评测5个源缺新caption、98个judge job不可用,部分时间指标沿用未改segmenter结果。评分缺失是测量状态,不等于caption一定错;不同历史技术重试预算、native视觉处理和API输入预算也不算严格计算量匹配。
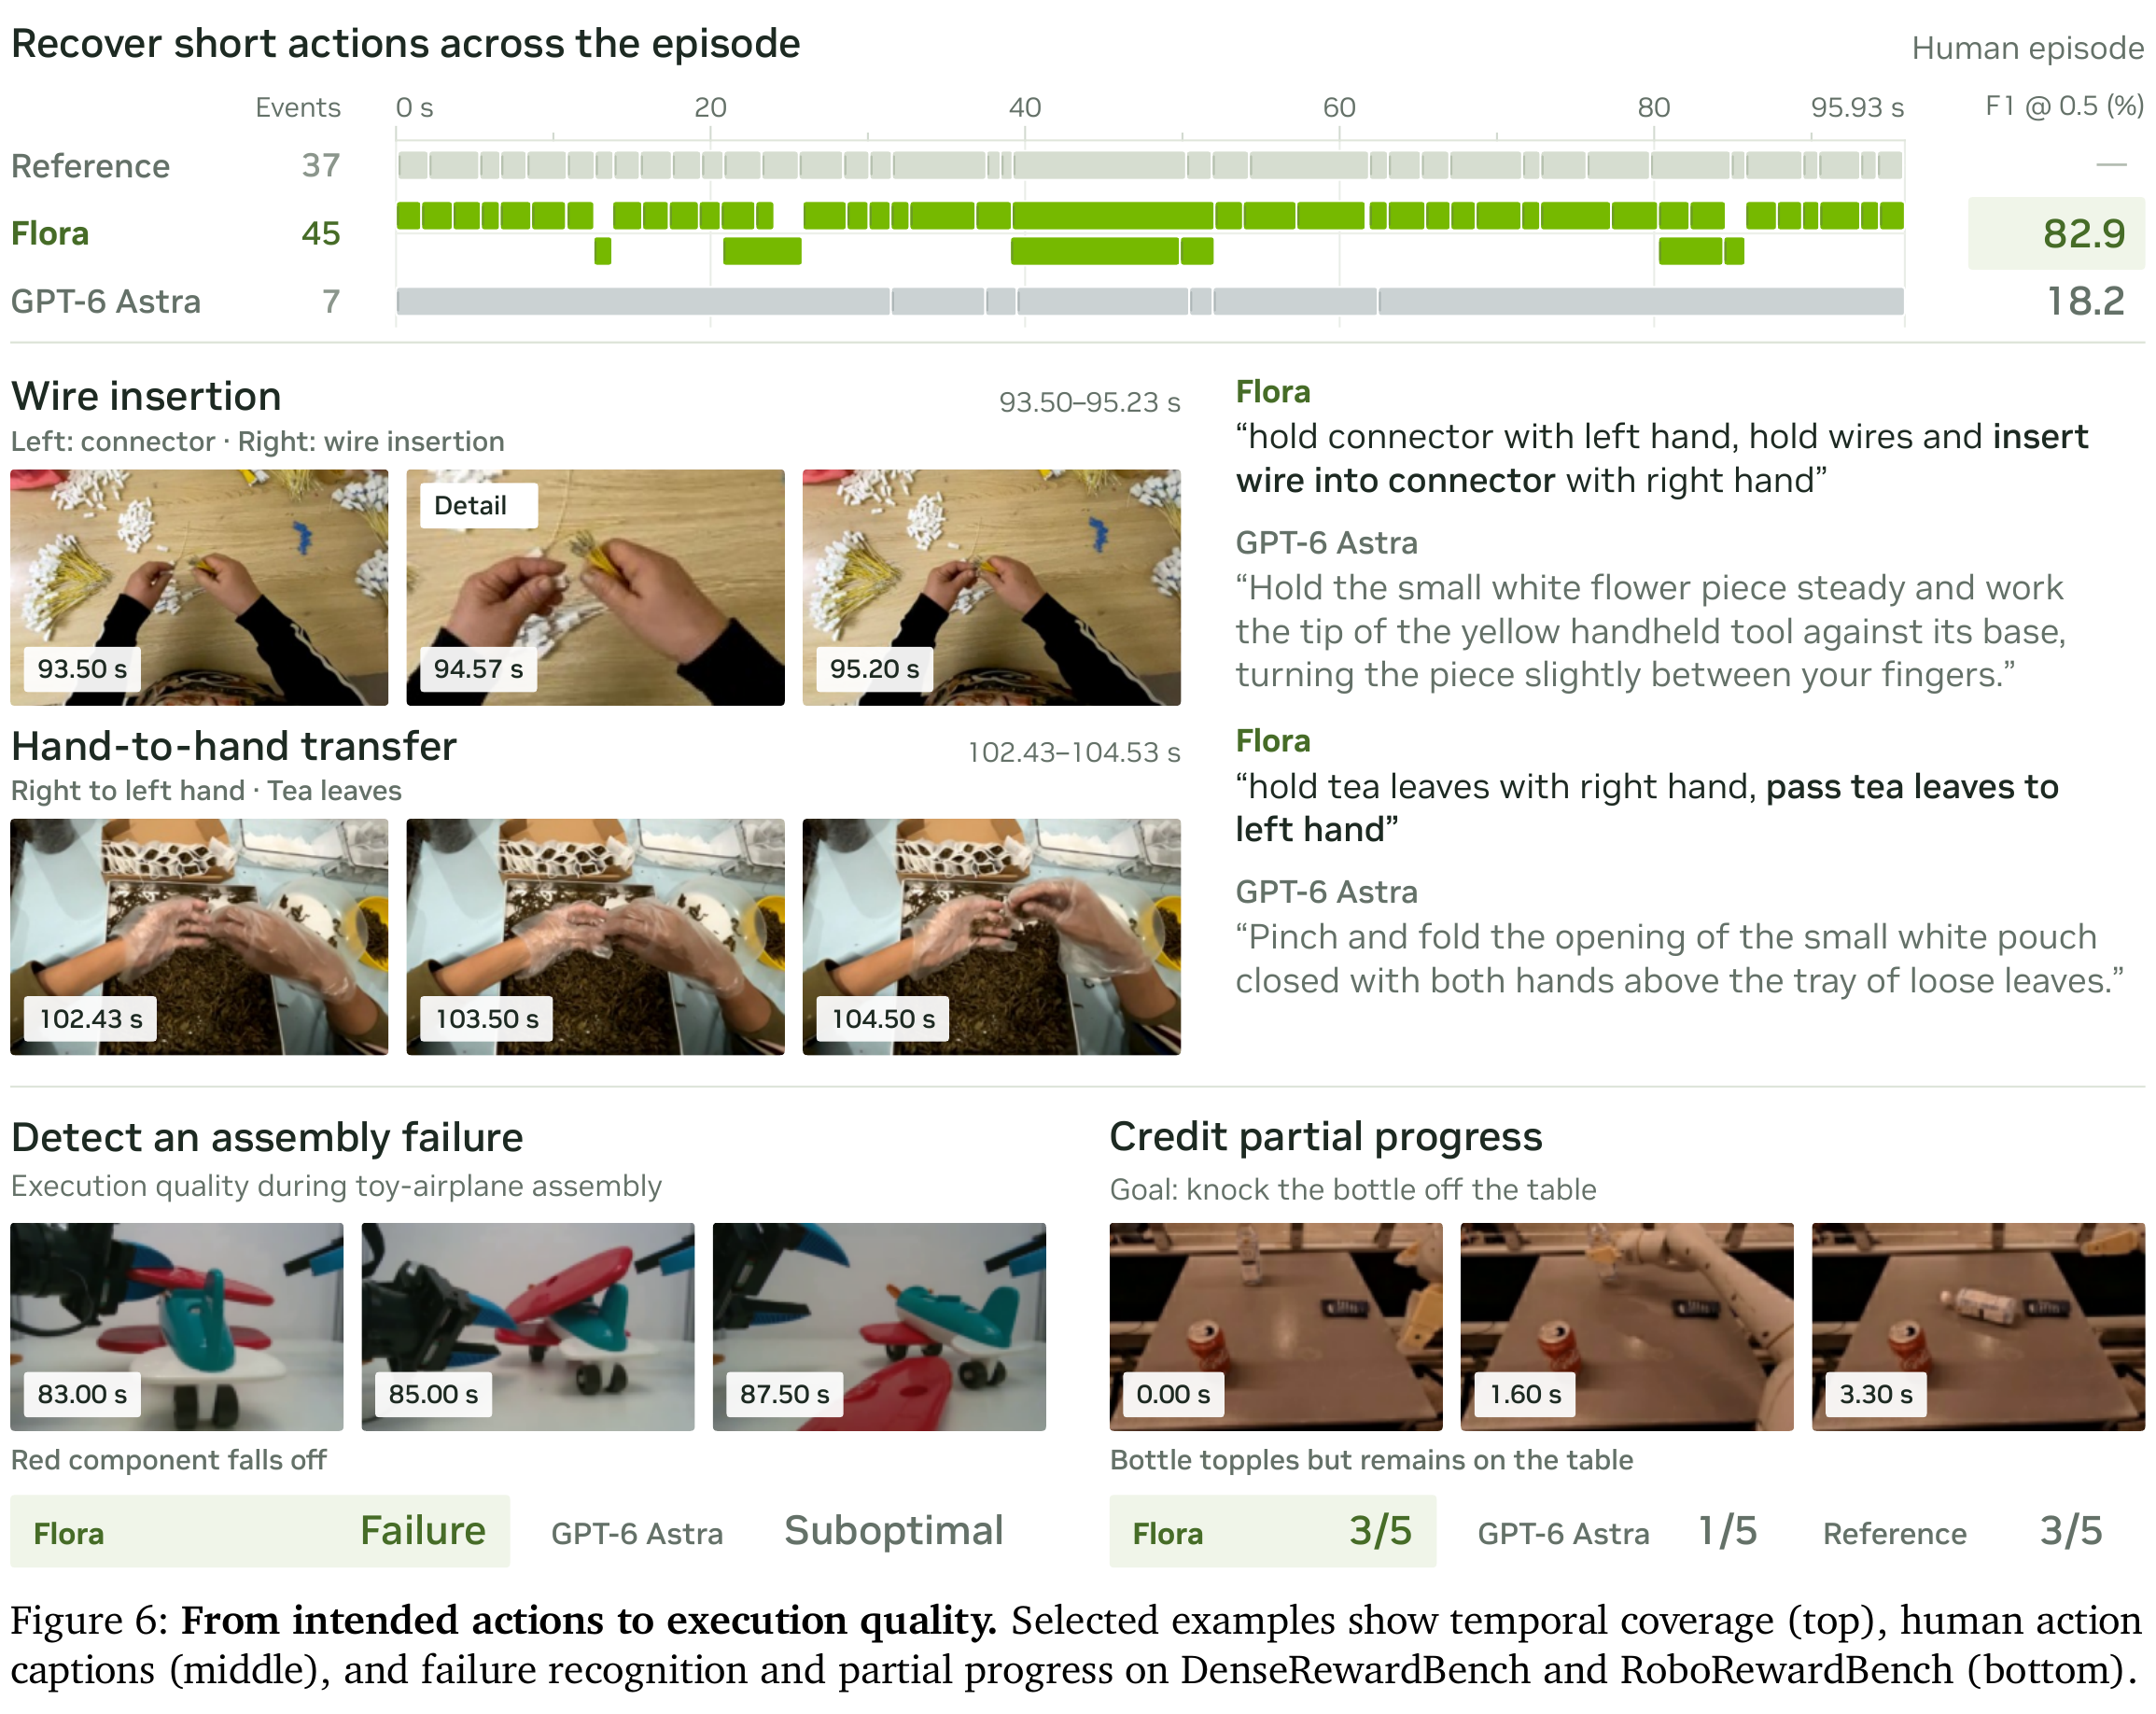
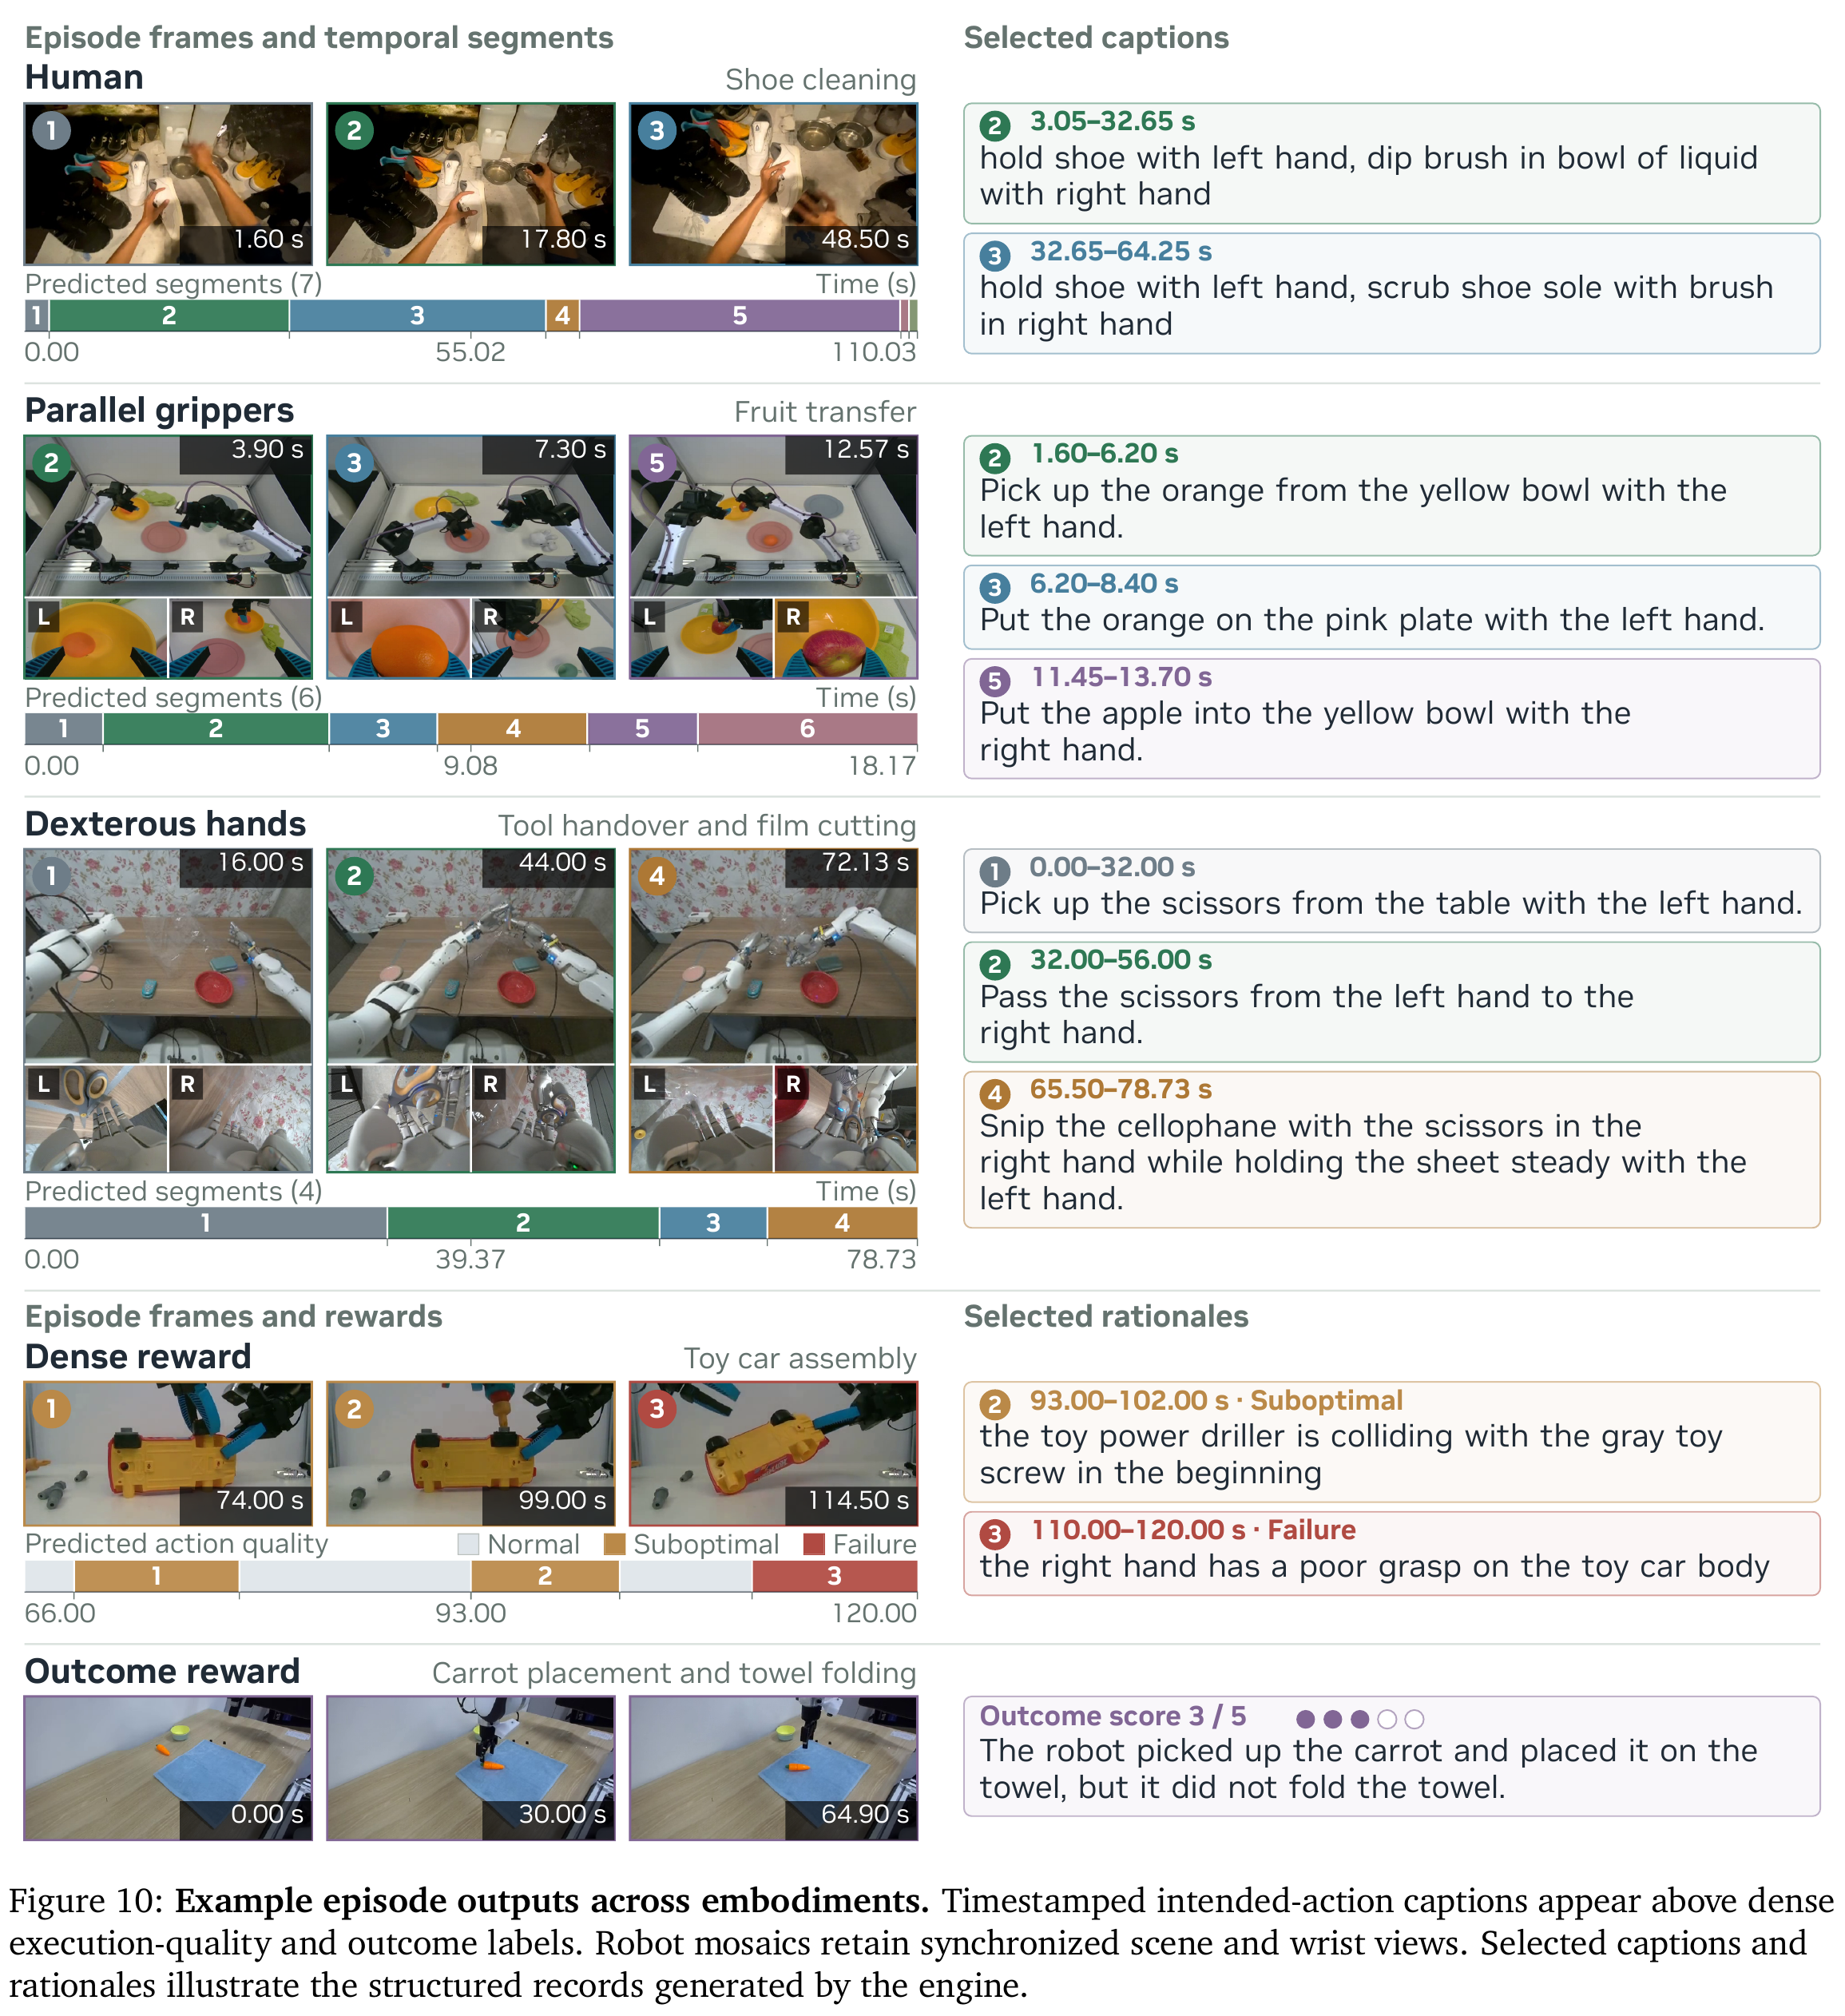
Figure 6 · 细动作、手角色与部分完成

细动作、手角色与部分完成
论文原图 · Figure 6 · p.7 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
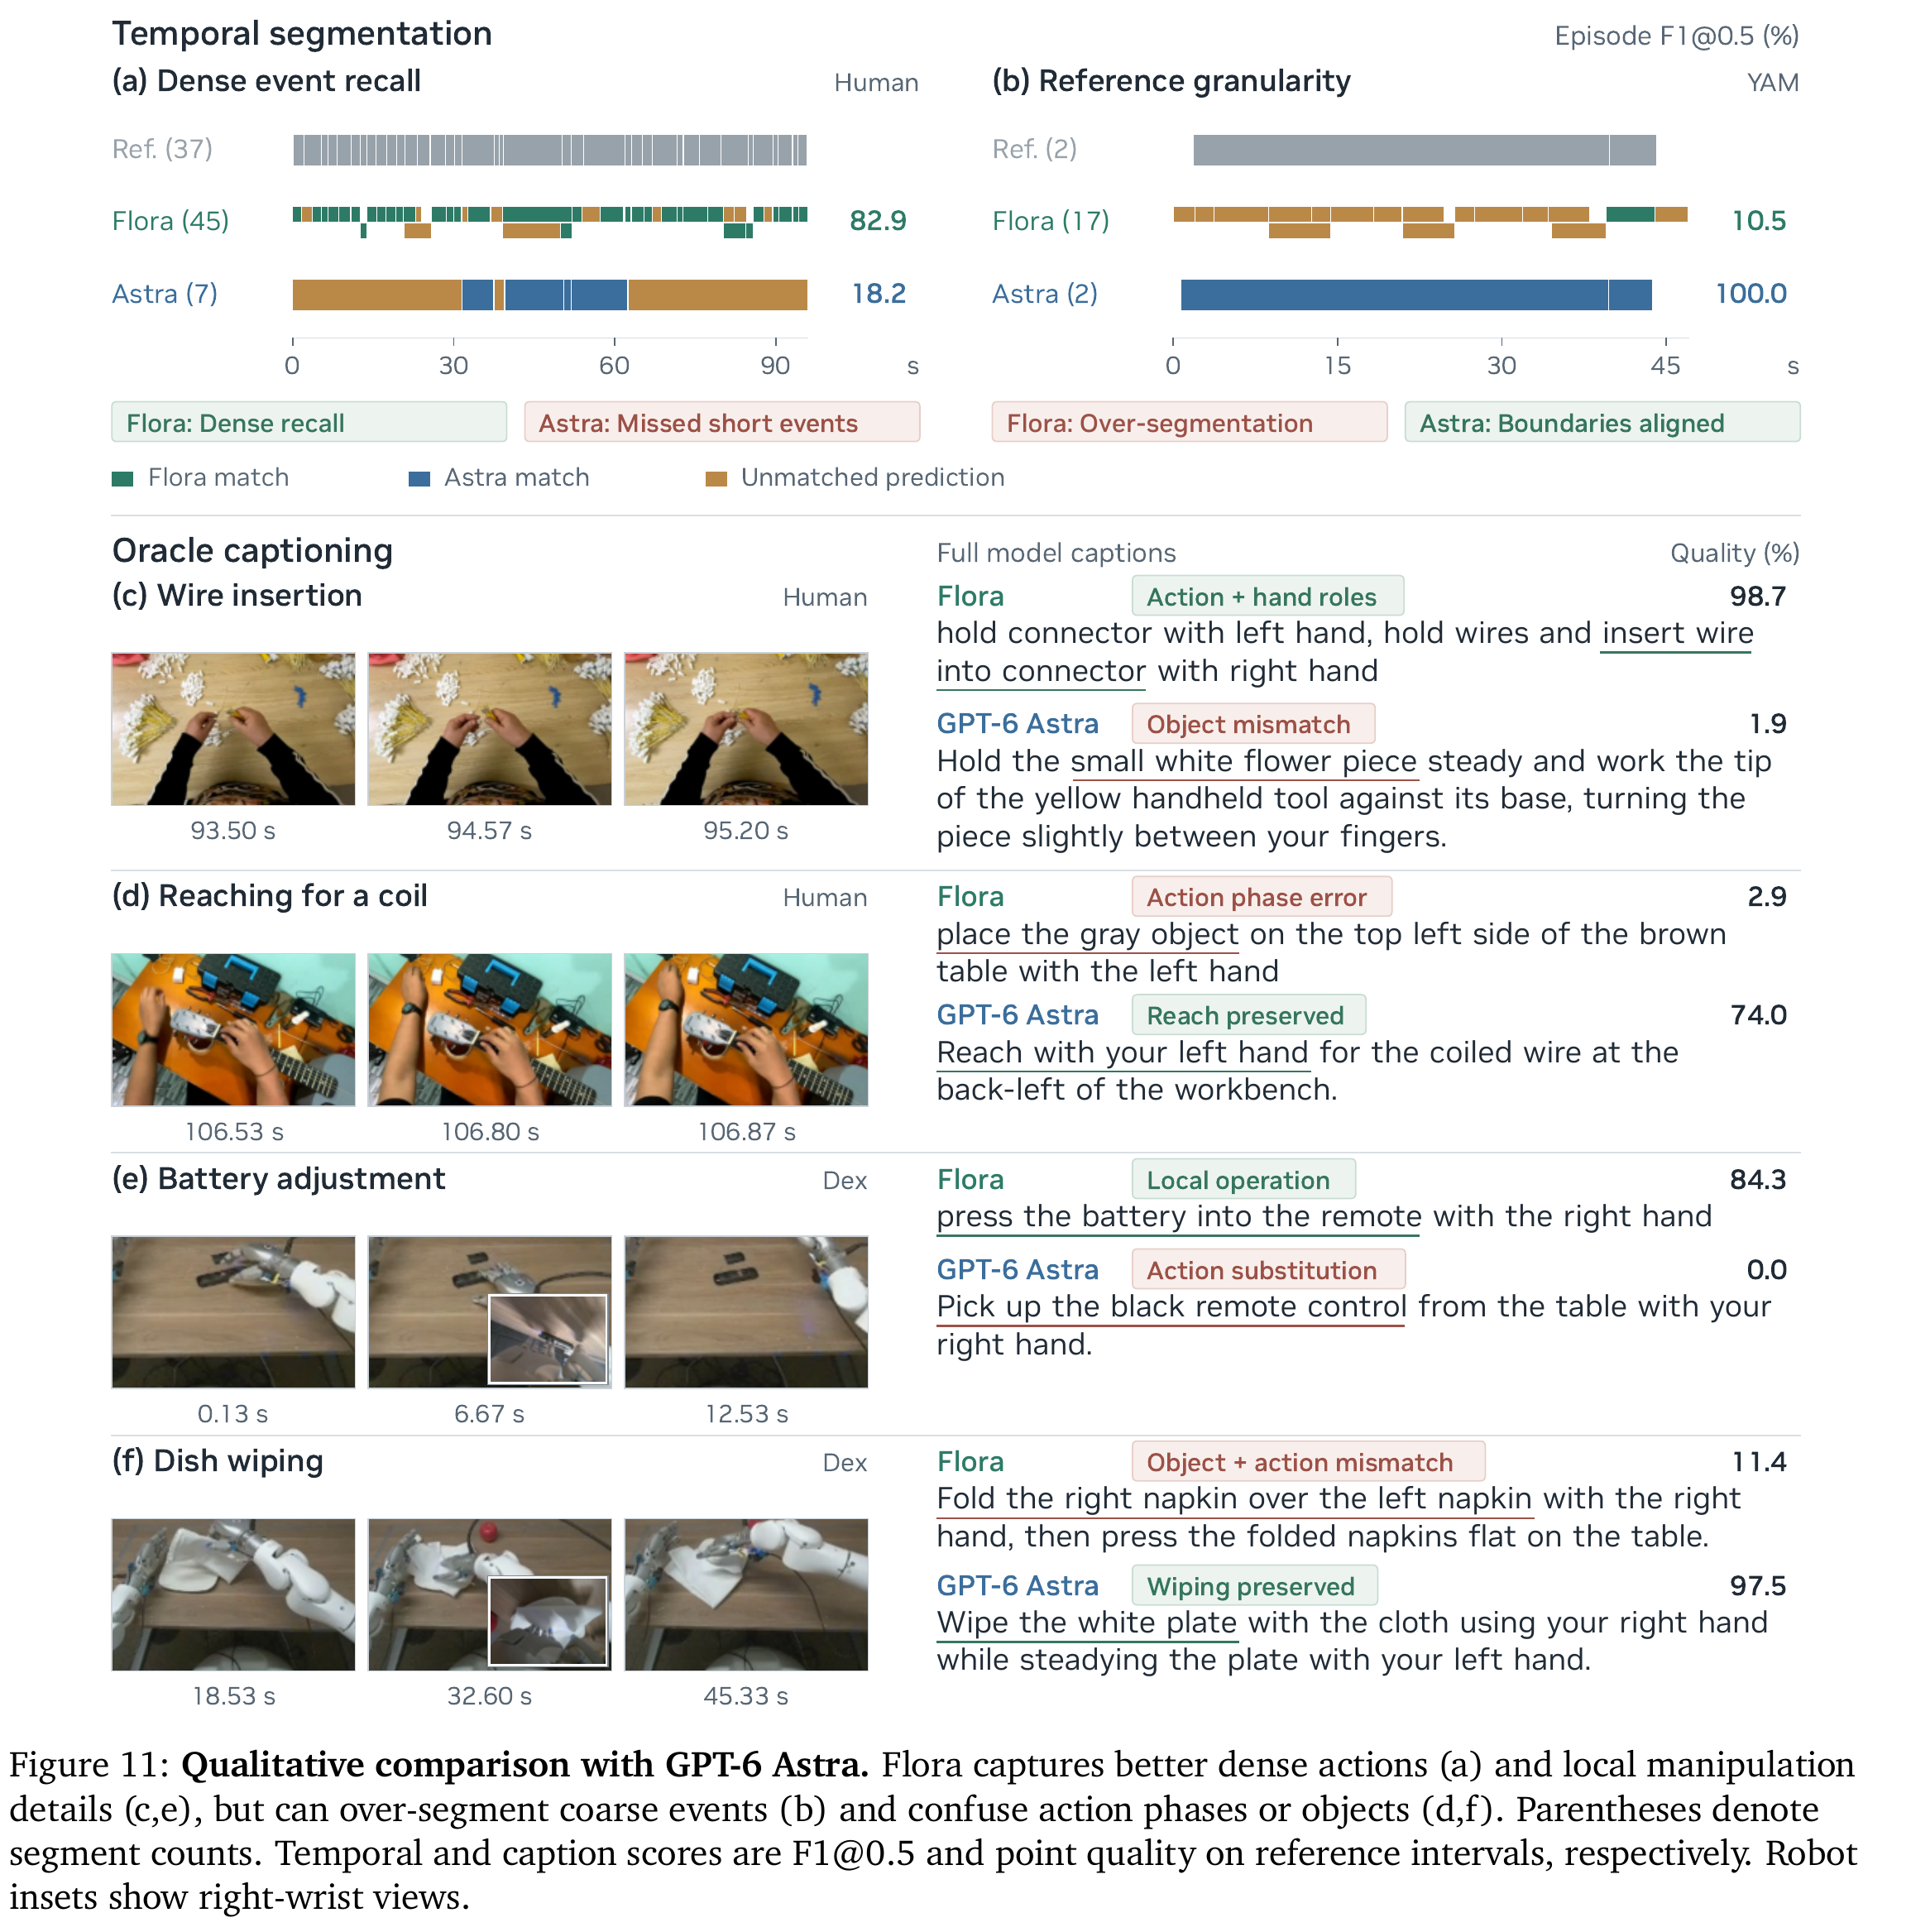
  1. 顶行在一条精选人类轨迹里找回更多短事件;82.9/18.2是这一条的F1,不是全测试集。
  2. 中间连接器、左右手传递说明动作名和双手角色要同时保留;下方用奖励区分掉落和局部进展。
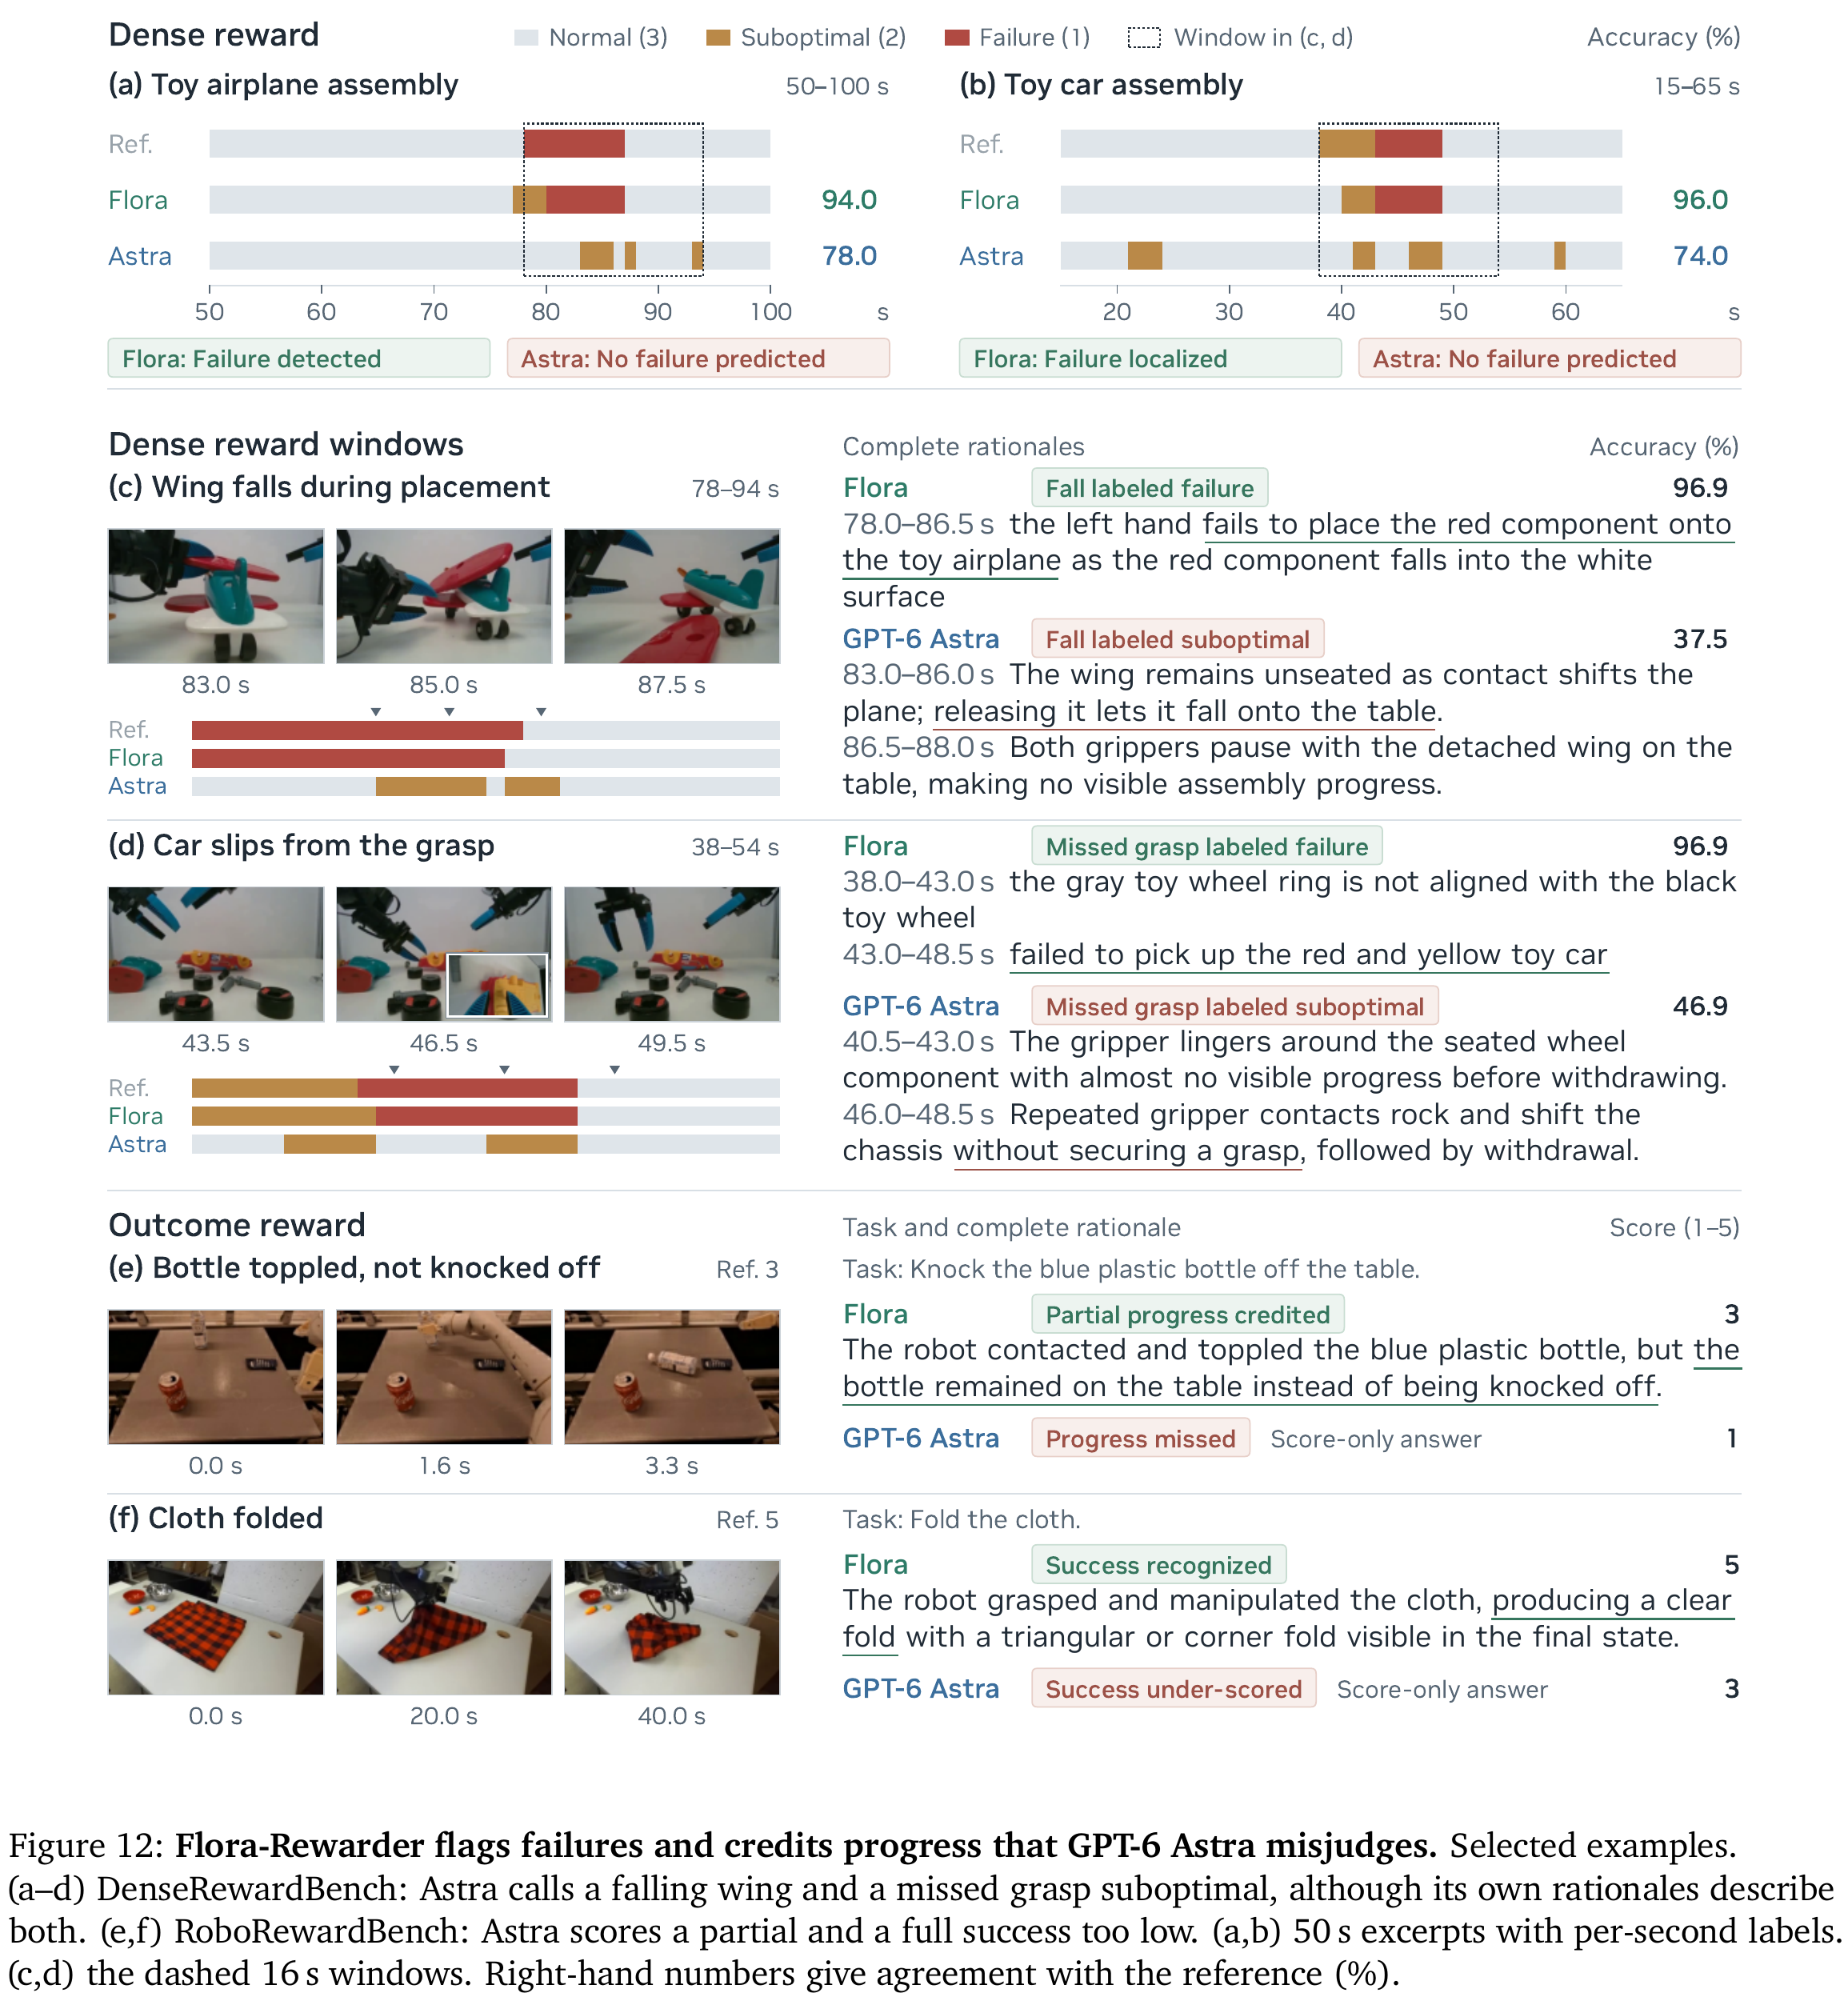
  3. 把瓶子推倒但仍在桌上,不能算完成“推下桌”;3/5体现部分完成,不是3次成功。

Figure 10 · 跨本体输出记录长什么样

跨本体输出记录长什么样
论文原图 · Figure 10 · p.26 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 人、夹爪、灵巧手的caption保留对象、左右手与动作意图;多视角在同一时刻拼成mosaic。
  2. 下方dense告诉何时碰撞/抓握失误;outcome说明拿了胡萝卜但没叠毛巾,所以只部分完成。
  3. 语言标签提供语义,不含足够的3D姿态、接触力或机器人动作参数。

Figure 11 · 反例:过分段和动作阶段混淆

反例:过分段和动作阶段混淆
论文原图 · Figure 11 · p.27 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 同样是高密度分段,有的episode能找回短事件,有的会把2个参考事件切成17段而降到10.5。
  2. c/e里FLORA保留插线和装电池;d/f里把伸手写成放置,把擦盘子写成叠纸巾。
  3. 这是正反例并列的精选诊断,提醒数据引擎仍需granularity策略和质量抽检。

Figure 12 · 失败召回的收益与误报代价

失败召回的收益与误报代价
论文原图 · Figure 12 · p.28 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. Astra文字有时描述了掉落,却给suboptimal;FLORA把严重程度标为failure。
  2. 结果评分例子保留部分完成与完整成功的差别。
  3. 全文同时指出FLORA把约11%的normal步骤报为failure;离线筛选阈值要检查误删好数据的成本。

08 · 每天20万小时与125×成本,逐个拆分母

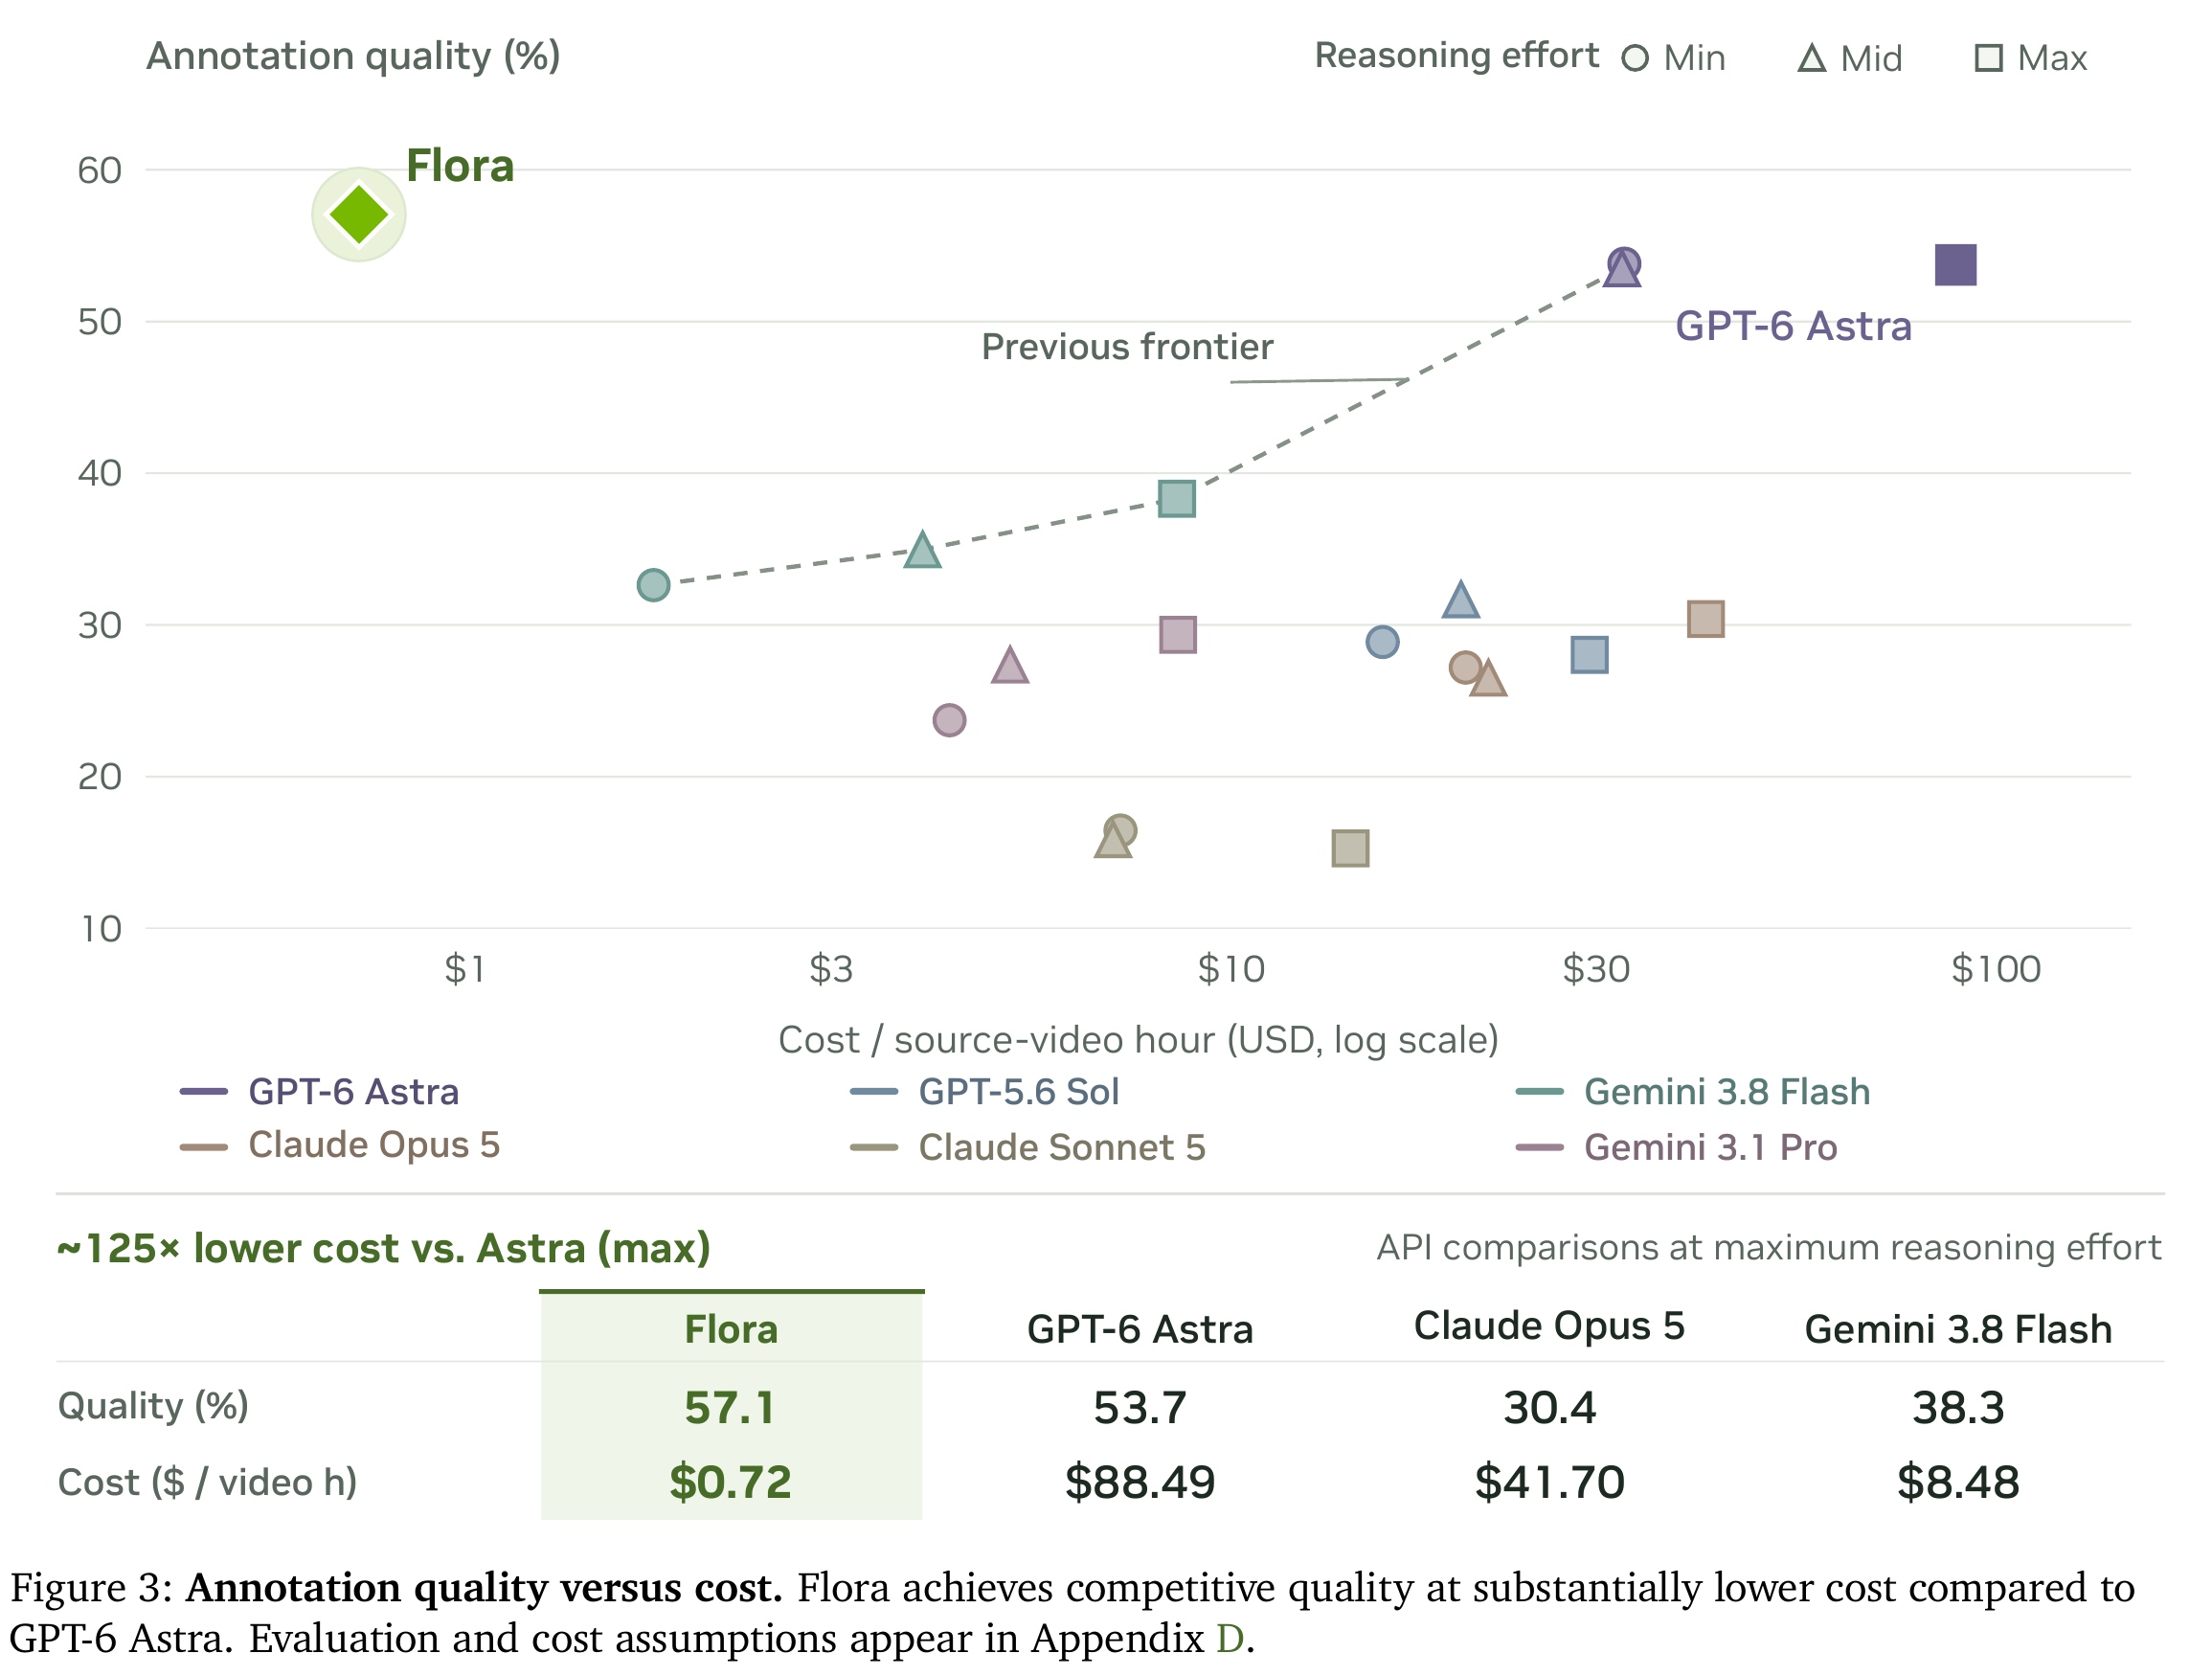
Figure 3 · 125×便宜的分母是什么

125×便宜的分母是什么
论文原图 · Figure 3 · p.2 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. 横轴每源视频小时美元成本为对数,纵轴是50条episode子集的复合标注质量;不是机器人SR。
  2. FLORA0.72美元来自8GB300、10美元/GPU小时、假定服务吞吐的成本模型;Astra88.49来自已返回usage的API调用。
  3. 质量点57.1/53.7没有完全匹配reference版本;未定价请求、训练、存储和部署开销未全部计入。

作者生产报告:512张GB300每天标注20万源视频小时。多机位是否逐视角折算会影响读法,应以source-video口径理解;这不是机器人一天新产生20万小时经验。成本和吞吐图是另一套50episode条件分析,不能拿生产报告为其中每项假设背书。

Eq.9:每源视频小时标注成本

CFlora=p·g·N/(3600·H·S)

p / g
假定每GPU小时价格10美元,GPU数8。
N / H / S
50条episode,源时长4483.54秒=1.24543小时,假定1.23495条episode/秒。
代入原文参数:10×8×50/(3600×1.24543×1.23495)≈0.7224美元/源视频小时。Astra最大effort88.4922/0.7224≈122.49,文中概称125×。工程场景S=.70804–1.74862对应0.5102–1.2600美元,不是置信区间。

服务吞吐来自先前部署研究的负载660窗口/890caption,不是发布RL checkpoint的逐请求实测率;生产GPU小时分母尚未核实。API成本按2026-10-04标准价计分段+预测区间caption,7062次物理尝试中106次无usage未定价。训练、构建参考、gold-caption、裁判、存储与部署开销不在完整账单内。

50条里20human/15夹爪/15灵巧手;质量先在每本体对分段、gold描述、联合三项等权,再三个本体等权,得57.1。API原始参考快照与FLORA当前快照未完全一致;episode bootstrap只反映样本不确定性,不覆盖裁判、生成、参考和服务变化。
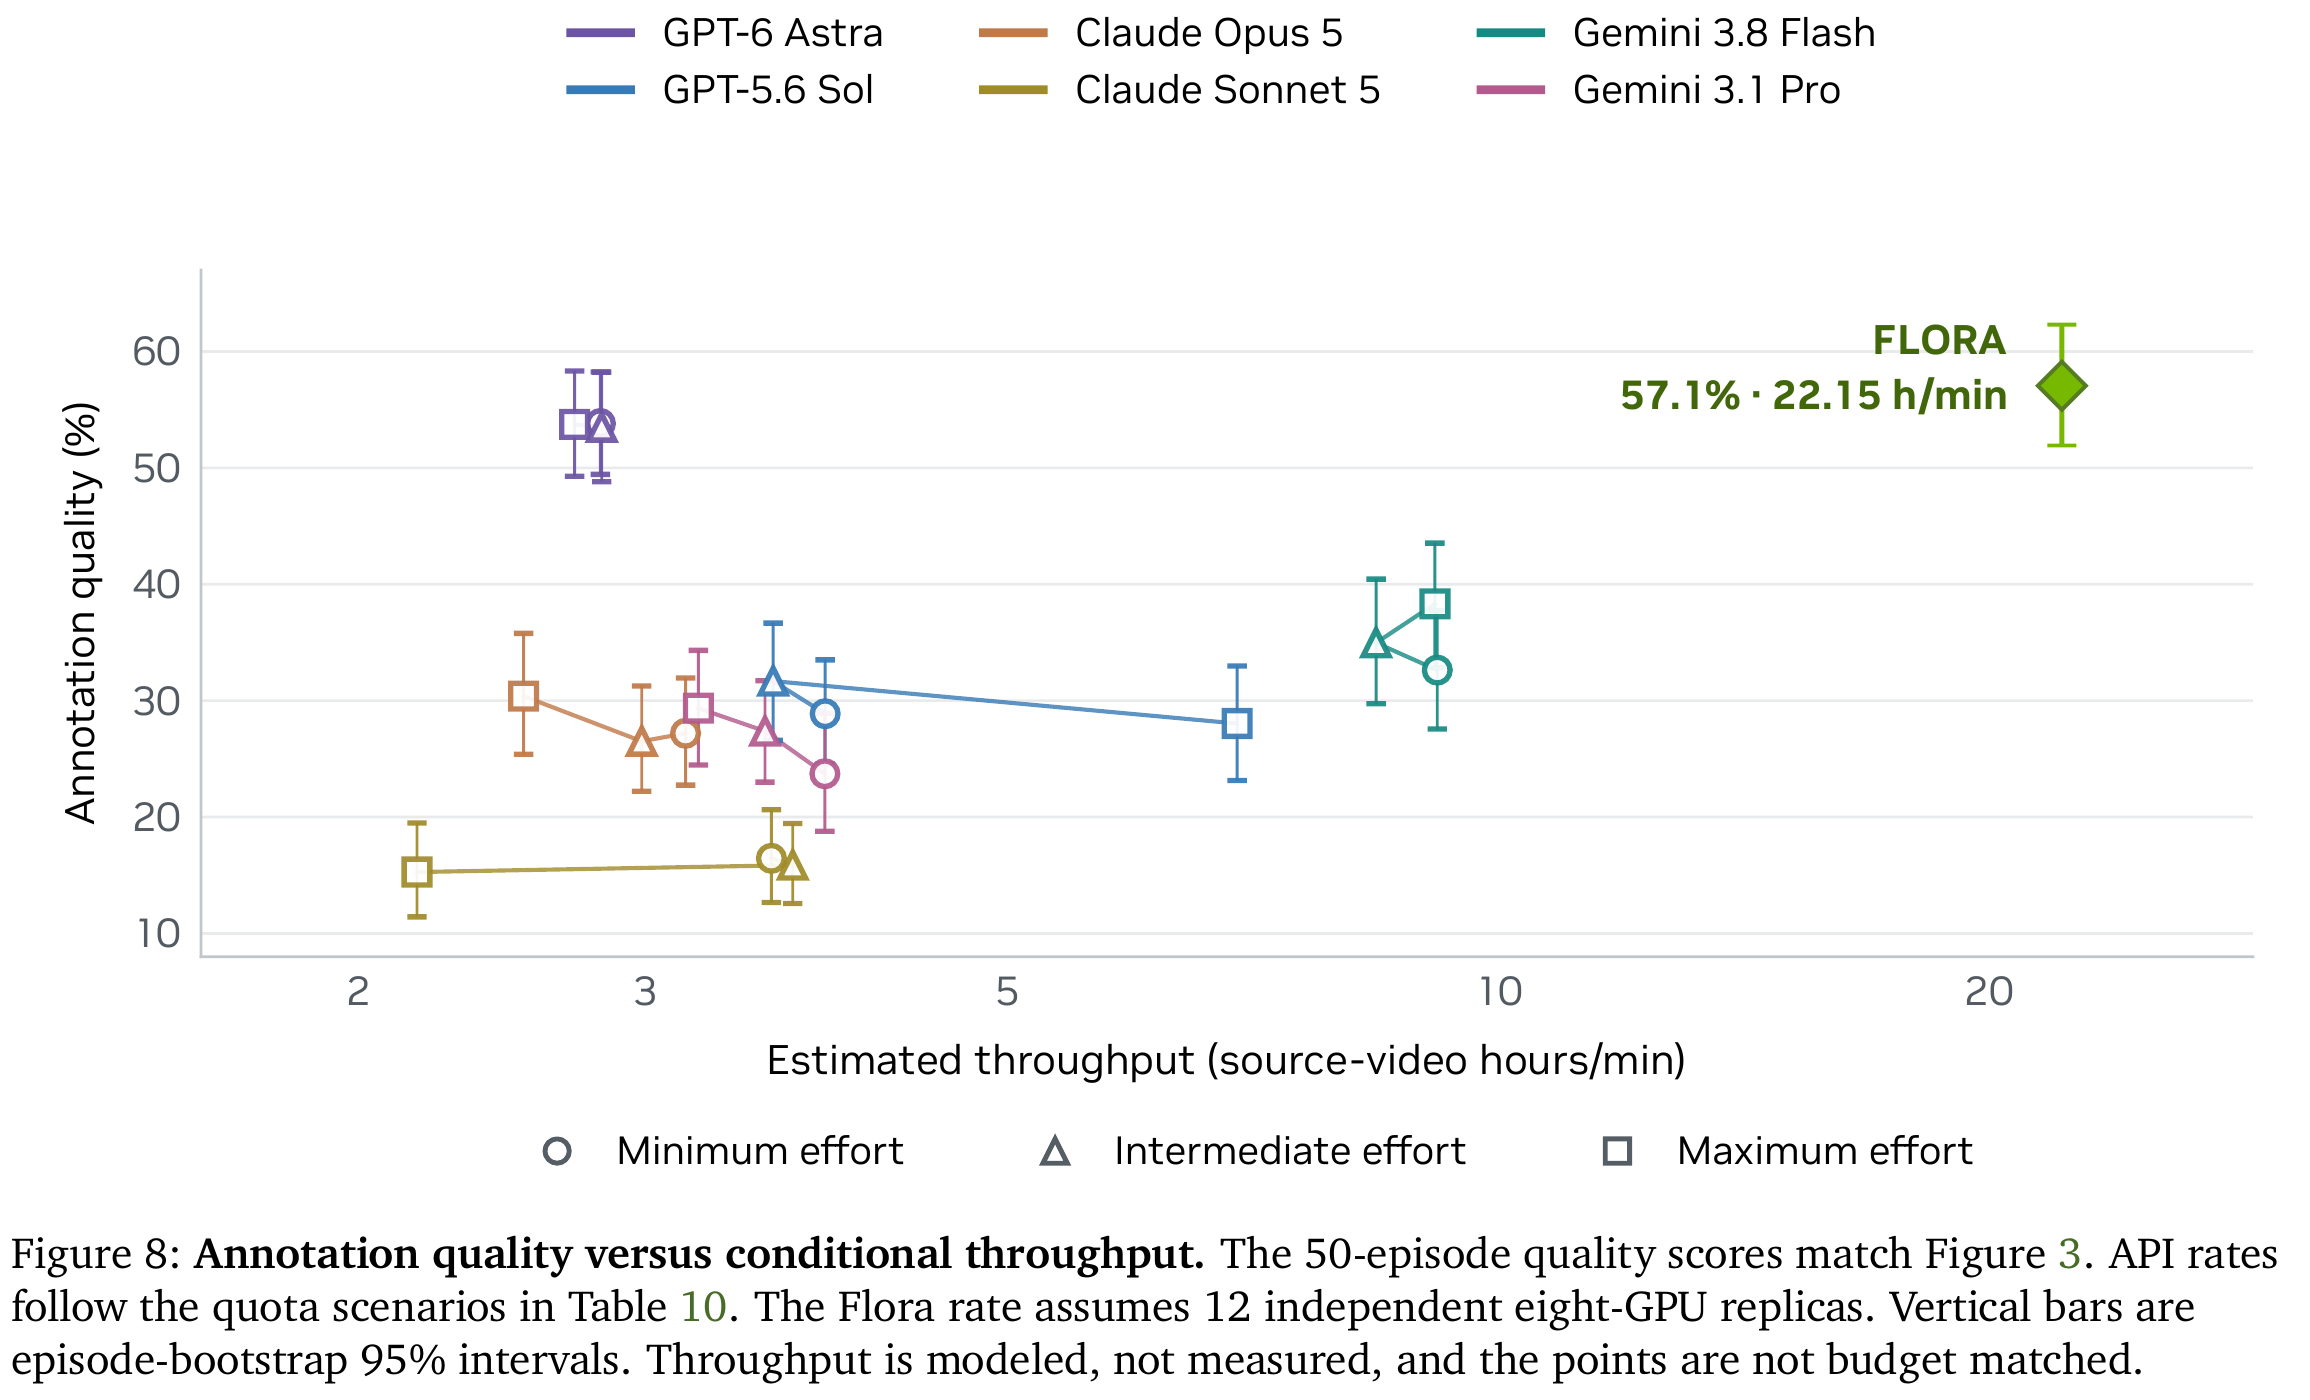
Figure 8 · 吞吐横轴是条件估计

吞吐横轴是条件估计
论文原图 · Figure 8 · p.24 · 350 DPI 裁剪 · 核对原文 · 点击原图放大。
  1. FLORA22.15源视频小时/分钟假设12份独立8GPU副本,即96GPU线性扩展;不是已测96卡服务结果。
  2. API点来自指定RPM/TPM配额的理想上限,未包含实际服务波动和所有每日额度。
  3. 纵向误差条是episode bootstrap的质量区间,横轴工程假设并没有因此成为统计测量。

Eq.10、11:API配额天花板与GPU副本扩展

Qₘ=H·min(Rₘ/Aₘ,mink∈KₘLₘ,k/Tₘ,k)
Q₈ᵣ=r·60HS/N

API的R是每分钟请求上限,A是这一组episode请求总数;L/T为各类token配额与总需求比。取最紧瓶颈乘源时长H,得到源视频小时/分钟。GPU的r是8GPU副本数,S为假定episode/秒,乘60换成每分钟。

代入原文:1份8GPU副本约1.8457视频小时/分钟;12份=96GPU,线性假设得22.15。费用假设16美元/分钟,虽低于对比API最低条件花费16.08,但不是每个API点严格等预算,也未测到真实96GPU吞吐。

因此原截图“1/25”与这版PDF不一致:本页按官方2026-10-20 PDF及附录D写约1/125的条件成本估计。实际部署应测decode、I/O、模型服务和质量抽检全链路,再计算自己的价格。

09 · 对你关心的人类数据与WAM训练有什么用?

解释性推断:最直接的收益是为Ego/机器人混合语料建立相似的时间语言接口,让“按小时混合”进一步变成“按技能覆盖、手角色、任务粒度、执行质量混合”。它补齐的是数据选择与监督层,无法独自补齐人机几何对齐、可执行动力学或WAM实际控制接口。

  1. 先建可审计小集:人工检查短动作、并发双手、遮挡、失败后恢复、同物体不同意图,分别看边界召回与caption事实错误。
  2. 保留质量和意图两列:失败片段对恢复训练可能有价值;不要一律删低分,也不要把suboptimal等价于“没完成任务”。
  3. 把本体和来源留在样本里:相同动作词不保证相同动作向量。FLORA语言标签可以接UniWAM式物理语义,但不能自动成为SONIC token监督。
  4. 做下游对照:固定policy、训练步数、数据量,对比人工标签、原始自动标签、经过抽检/过滤的FLORA标签;同时测语言跟随、ID/OOD、长程恢复和真实执行。
自测:过程失败召回53.3%,能否放心自动删除所有低分数据?
还要看precision、正常片段误报率与任务分布;约11%正常步骤会被误判失败。恢复训练还需要保留部分失败。离线抽检和下游控制实验决定删除阈值,而非只看召回。

原文定位:§2结果、§4方法;附录A完整表、B分段/语义评测、C奖励协议、D成本、E正反例、F分段/描述训练、G三奖励实现、H相关工作。官方项目 · 开源模型。