TOPIC 02 · VERIFIED ROUTE

VLA + RL:从动作模仿到闭环自我改进

截图的主线是对的:VLA 先用大规模数据建立跨任务先验,SFT 把它适配到机器人,RL 再通过环境反馈补上分布偏移、错误恢复与策略最优性。但“用了 RL”不是一个方法类别;真正要区分的是反馈来自离线数据、在线真机还是世界模型,以及更新的是整条生成链、动作块、residual,还是仅仅一个 critic。

● 绿色 = 身份已核验 + PDF + Zotero + 独立 HTML路线按学习依赖排列,不按发布时间排列

§1 基础:先分清 VLA、SFT、offline RL 与 online RL

先学会读动作头和数据分布,再进入后训练。RT-2/OpenVLA/π₀ 是 VLA 基座;IQL、AWAC 与 HIL-SERL 分别提供离线、离线到在线、真机人类介入三套 RL 直觉。

关系图 1 · 不是四种互斥算法,而是一条策略生命周期
数据先验 → 任务适配 → 反馈优化 → 部署再采样
PRETRAINVLA 基座RT-2、OpenVLA、π₀ 从跨任务数据学“看见什么通常该怎么做”。
→
IMITATIONSFT / 行为克隆用目标任务示范拟合动作;上手快,但只会模仿数据覆盖过的状态。
→
OFFLINE RL固定数据内挑更好的动作IQL/AWAC 学 value/advantage,但不能主动发现数据之外的失败。
→
ONLINE / REAL闭环试错与纠正HIL-SERL 在真实执行中收集新状态,用奖励和人类介入持续更新。

关键:SFT 回答“专家当时做了什么”;RL 回答“这个动作后来带来什么结果,以及还有没有更好的动作”。

基础补图 · PPO 与 GRPO 怎样得到 Advantage?

这张图属于“策略梯度如何把结果反馈给动作”的基础层。两者都先由策略采样、用奖励评价结果,再通过受约束的策略目标更新参数;主要区别是优势值的基线从哪里来。
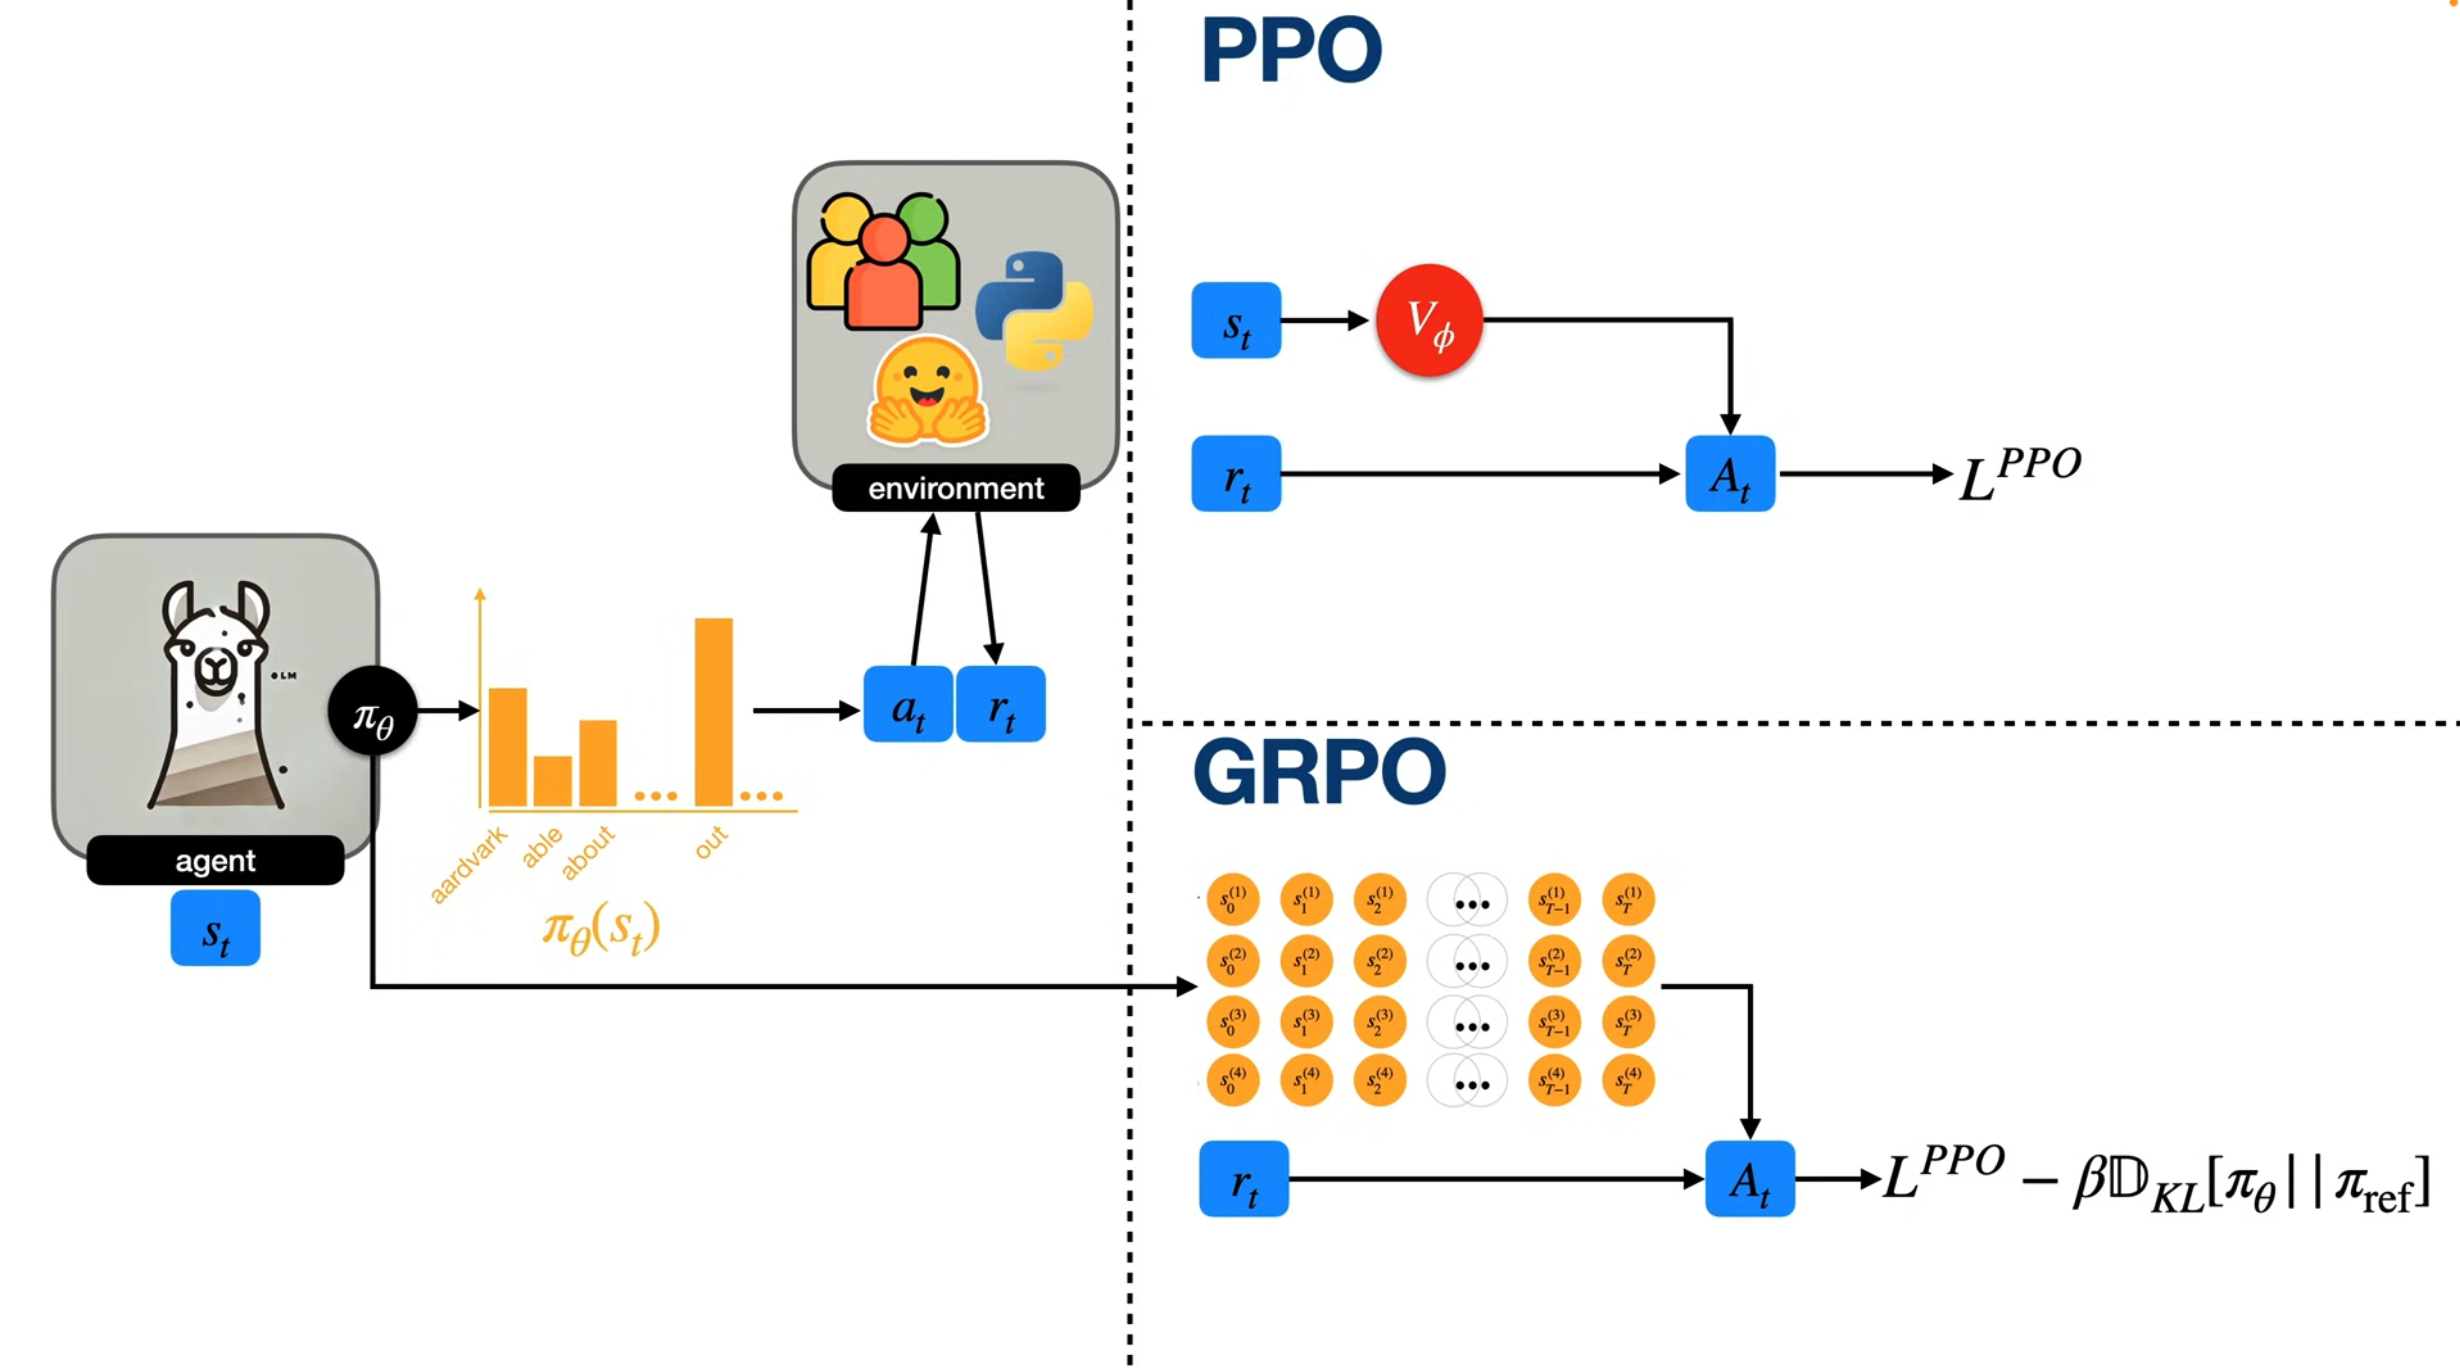
PPO 与 GRPO 对比示意:左侧策略与环境交互;右上 PPO 借助价值函数估计优势,右下 GRPO 比较同一条件下多条采样轨迹的奖励
用户提供的概念截图;手机上可横向滑动或点图查看原尺寸。图中的 Llama、Python 与环境是语言模型示例,用它理解算法结构,不能直接当作真机控制实验。
PPO · 学一个基线价值函数 Vφ 辅助估计 Advantage策略采集轨迹,同时训练 value/critic 估计未来回报;常结合 GAE 计算各步优势,再用 clipped policy objective 更新策略。图里的单个 rt 只是简写,不能直接把优势理解成“即时奖励减当前价值”。
GRPO · 组内相对基线同一条件采样多条结果,比较谁更好用组内奖励均值(常再除以标准差)构造相对优势,省去独立 value/critic;它仍沿用 PPO 式概率比与 clipping,原始方法还加入参考策略 KL 约束。代价是每个条件要采样一组可比较结果。

放回具身 RL:这张图解释的是优势估计方式,不决定数据是离线、仿真还是真机。将 GRPO 搬到机器人时,要先保证多条轨迹的任务与起点可比,并计算重复 rollout 的成本。后面的 DPPO、πRL 还要解决生成式动作策略的概率接口。依据:PPO、DeepSeekMath §4(GRPO)。

§2 RL 到底给 VLA 带来了什么

不要把训练任务涨点误当泛化。先读系统实证,再决定要优化视觉、语义、执行鲁棒,还是仅仅提高熟悉任务成功率。

关系图 2 · RL 修补的是闭环分布,不会自动补齐所有泛化
失败状态 → 反馈 → 信用分配 → 行为改变
SFT 缺口动作改变下一次输入一次小误差会把机器人带到示范里没见过的状态。
→
FEEDBACK奖励 / 成功分类器 / 偏好把“最后是否完成”或“哪条轨迹更好”转成学习信号。
→
CREDITCritic / Advantage判断更早的哪些动作应负责,把末端结果传回动作选择。
→
实际收益恢复、抗干扰与任务最优性不等于自动获得新物体识别、语言理解或跨本体能力。
开放环境基座

§3 轻量在线 RL 与真机落地

工程主流是保护预训练基座,只训练少量 residual、critic 或动作模块,并用人类介入和异步采样降低真机成本。

关系图 3 · 真机在线 RL 的安全闭环
不是整模型边跑边乱改
SAFE START示范 / SFT checkpoint先让机器人具有基本可执行行为,避免从随机动作探索。
→
REAL ROLLOUT策略执行 + 人类接管只在困难或危险状态纠正,并记录动作来源、奖励与下一状态。
→
OFF-POLICY LEARNERReplay + Critic旧演示、纠正和自主数据可反复抽样;一次昂贵交互支持多次更新。
→
SMALL UPDATEResidual / Adapter / RL token优先保护 VLA 语义先验,只修正控制薄弱环节。

HIL-SERL 是理解这条链最好的系统起点;EXPO-FT、RL Token 等再研究如何把更新缩小到更轻量模块。

离线 → 在线
系统与可靠性

§4 离线 RL 与小数据冷启动

没有大量真机交互时,关键是只在数据支持范围内提取“哪些动作更好”,同时让算法尊重 VLA 的 action chunk 或 flow 表示。

关系图 4 · 离线 RL 为什么位于 SFT 和在线 RL 之间
固定 replay,不增加真实交互
DATASET示范 + 历史失败轨迹同时包含好动作、次优动作和数据从未覆盖的空白区域。
→
VALUE LEARNINGIQL / AWAC / RankQ从回报或轨迹排序估计哪些已记录动作更值得模仿。
→
CONSERVATISM不要相信数据外动作critic 在 OOD 动作上容易虚高,策略必须受行为数据支持约束。
→
HANDOFF作为在线训练的安全初始化先挖完历史数据价值,再用少量真机交互修补覆盖空白。
保守价值学习
VLA 原生结构

§5 生成式动作头的原生 RL

扩散与 flow 不是普通高斯 actor。DPPO 把去噪链视为内部 MDP;ReinFlow 用可学习噪声让确定性 flow 具备 likelihood 与探索。

关系图 5 · 同一个生成式动作头,可以在四个位置接入 RL
区别看“RL 改了生成过程的哪里”
FULL CHAINDPPO把每一步 diffusion denoising 当作内部决策,用 PPO 对完整生成链反传。
LATENT INPUTDSRL冻结原 diffusion policy,只学习更有价值的初始/条件 latent noise。
FLOW TRAININGReinFlow / SAC-Flow / πRL给确定性 flow 加探索和概率路径,使 actor-critic/PPO 可训练。
TEST-TIMEQGF基座不重训,采样时用 critic 的价值梯度修正动作流。
↔
PREFERENCE / GEOMETRYFlowPRO / SA-VLA用轨迹偏好或空间几何构造比手写奖励更密集的优化信号。
Flow · 推理期

§6 自提升:RL 生成数据,或在世界模型里想象

PLD 用 residual RL 发现失败并生成恢复数据,再蒸馏回 VLA;RISE 则把 rollout 搬进 compositional world model,用想象优势更新策略。

关系图 6 · 自提升的两条闭环
真实数据闭环 vs 想象闭环
REAL LOOPProbe → Learn → DistillPLD/Self-Improving VLA 用 residual RL 探测失败、生成恢复轨迹,再把新能力蒸馏回基座,部署仍保持简单。
IMAGINED LOOPWorld Model → Advantage → PolicyRISE/Dreamer 类方法在 learned dynamics 中批量 rollout,只把最有价值的更新带回真实策略。

共同风险:真实闭环受硬件与人工成本限制;想象闭环受 world model 偏差限制。两者都必须回到真实闭环评测。

数据与阶段闭环
想象 RL

截图条目核验说明 · 2026-08-10 更新

截图中的 11 个黄色名称现已全部对应到公开论文,并完成 PDF、Zotero 与独立精读页。两处二手写法已纠正:STARF-VLA → STARE-VLA;Kai-0 → χ₀。其余简称对应 RL Token、SAC Flow、πRL、SA-VLA、FlowPRO、DSRL、QGF、RL-VLA³ 与 LWD。

截图写法核验后的正式身份路线定位
DSRLSteering Your Diffusion Policy with Latent Space RL冻结 diffusion policy,学习潜噪声策略
QGFTest-Time Gradient Guidance of Flow Policiescritic 只在推理时引导 flow
STARF-VLASTARE-VLA阶段级信用分配
Kai-0χ₀资源受限长程双臂可靠性