扩展实验
Isaac Lab test-content:99.6%,MPJPE-L 23.8 mm;不能混成 MuJoCo 横向基线评测的 98.7%。
2026-10-23 补充核读 · 本页依据本地 arXiv:2511.07820v3(2026-05-21),37 页,含 S1–S8;不是宣称已覆盖后续版本。本地 PDF · 固定版本 · 六篇链路
GMR 提供的机器人参考不是 PD target。SONIC 先把“想怎么动”编码,再结合“现在身体怎样”生成控制。理解这两条输入,才能解释为什么同一个 token 在不同状态下不应输出完全相同的关节目标。
| 层 | 输入 | 输出与频率 | 不能混淆 |
|---|---|---|---|
| 参考运动 → encoder | Eᵣ:机器人关节位置/速度,10 帧、间隔 0.1 s;Eₕ:人体 3D 关节,10 帧、间隔 0.02 s;Eₘ:当前上身 keypoints + 未来下身 | FSQ 后 2×32=64 维 token | 窗口长度与下发频率是不同概念;实时流如何补足窗口需核对实际 wrapper。 |
| 本体感知 → D꜀ | q、q̇、root angular velocity、projected gravity、previous action 的 10 步历史,均按部署可用观测构造 | D꜀(z,sᵖ) → 29 维目标关节位置;policy 50 Hz | 不是只输入 z 的固定运动解码器;高层 VLA 的 43/44 维状态不等于此观测向量。 |
| 辅助 motion decoder | 只输入 z | Dᵣ(z) → 重建机器人 motion command | 用于辅助重建/隐式重定向,不能拿它的输出代替有状态的 control decoder。 |
| 底层执行 | PD joint targets | 命令 writer 500 Hz 发送最新目标;operator 100 Hz;kinematic planner 10 Hz | 500 Hz 是命令传送,不等于神经网络每 2 ms 重新规划。 |
| whole-body VLA | GR00T N1.5 预测 64 token + 14 hand joints | 78 维 action;token-only streaming 可绕过 onboard encoder | 与 EgoHumanoid-V2 / KODA 的 64+12=76 维手接口不同。 |
解释性算例:同一个“伸手”token,站稳时和上身已经前倾时,D꜀ 可以因 sᵖ 不同给出不同腿/腰目标以补偿。若数据转换把人类关节直接填到 robot state,即便 token 对,条件分布也会错。再假设 PD 的 Kp=40 Nm/rad、目标 0.30 rad、实际 0.25 rad、Kd=1、速度 0.1 rad/s,则 τ=40×0.05−1×0.1=1.9 Nm;这是教学例子,不是 SONIC 实机增益。
约 700 h 人体 mocap 经 GMR / PyRoki 转到 G1并过滤,训练集为 611 h、317,189 clips、8,447 subcategories、100M+ frames。同步的人类/机器人/混合输入以重建、三对 token 对齐和 cycle loss 对齐,再联合 PPO 训练。Eₕ 因此学会直接进入共享 latent;“运行时不显式 retarget”不等于“训练不需要 retargeted data”。BONES-SEED 公开 288 h 是其中一部分,不能等同全部 611 h。
| 实验 | 数据/次数 | 观测、动作、时域 | 结果 | 边界 |
|---|---|---|---|---|
| Isaac Lab scaling | test-content 6,998 / test-repetition 6,306;50k training iterations;每配置 6 evaluation checkpoints | 局部参考 + 本体历史 → joint targets;50 Hz;clips 1–180 s;根/末端高度偏差 >0.25m 或 root angle >1rad 失败 | 42M:content 99.6%、23.8 mm;1.2M:98.0%、27.7 mm | 6 checkpoints 不等于证实 6 个独立训练 seeds;Fig.2 caption 的 seeds 用语与正文统计描述需谨慎区分。 |
| MuJoCo 横向 tracker | 相同三个测试集,同终止条件;多轮评估次数未另明确 | SONIC / GMT / Any2Track / BeyondMimic;local tracking,不要求全局路径误差小 | SONIC content/repetition/PHUMA:98.7/99.6/97.0%;BeyondMimic:81.6/85.8/73.4% | 训练源、retargeting、算力不同;不是 data-matched 架构因果实验。 |
| 速度 specialist 对照 | MuJoCo,命令 0–5 m/s;次数未报告 | SONIC + planner 对比 OpenHomie | survival 98.5% vs 43.0% | 不是 SONIC tracker 单模块消融,也不是实际 6 m/s 跑速保证。 |
| 维度 | 训练/测试关系 | 值 | 解释 |
|---|---|---|---|
| 新表演 test-repetition | 类型全重合、具体 clip 不重合;12 h | MuJoCo 99.6% | 可称 seen-type held-out,不是训练集表现 |
| 新内容 test-content | 182 subcategories 与训练 0% 重合;15 h | MuJoCo 98.7% | 任务集合/数量不同,不自动计算相对 repetition 的保留率 |
| 数据源/重定向 PHUMA | 外部视频运动恢复与不同 retargeting | 97.0% | 复合域移,不能独立归因单一维度 |
| 外力 | 约 11 kg 物体落到机器人 | 定性展示,次数未报告 | 不能推出任意碰撞安全率 |
| 复杂地面接触 | zombie crawl、cross-legged sit | 失败例,无分组统计 | 运动学限制/持续接触仍是边界 |
| 任务 / 训练示范 | 成功数 / 次数 | 成功率 | 95% Wilson |
|---|---|---|---|
| Apple→plate / 300;3-point | 18/20 | 90% | 69.9–97.2% |
| Carrot pickup / 3,900 multi-object | 15/20 | 75% | 53.1–88.8% |
| Scrub pickup / 同一 object-pickup policy | 19/20 | 95% | 76.4–99.1% |
| 脚开垃圾桶 / 200 | 7/10 | 70% | 39.7–89.2% |
| 易拉罐→垃圾桶 / 1,000 multi-object | 6/10 | 60% | 31.3–83.2% |
| 钻机/盒子搬运 / 300 | 7/10 | 70% | 39.7–89.2% |
五任务均值 75% 将 carrot/scrub 先平均为一个任务;不是六行直接平均。G1 29 actuators;whole-body hand 接口为 14 维,本文相关章节未完整报告手硬件/相机清单、完成时间及安全停止总数。S1.1 声明演示执行无需人工干预;不能据此补造每条试验的安全日志。
运动 tracking 的 123 条真机序列各一次:成功率 99.2%,MPJPE-L 25.7 mm,仿真为 100% / 22.3 mm;脚部 53.7 vs 29.0 mm 的 gap 最大。本文给的是四舍五入百分比,本页不把推回的整数当原始失败记录。
SONIC 的论点:运动追踪(motion tracking)是人形控制的可扩展基础任务—— 它提供逐帧追踪目标、可复用人类动作捕捉数据,并减少逐任务重设计奖励的需求。 本文在所测试的数据、模型和算力范围内观察到扩展收益;仍有明确的奖励、惩罚和域随机化设计。
现有人形控制器的扩展性困境:每个新行为都需要手工设计奖励函数(locomotion 的奖励对 dancing 毫无用处), 对抗性模仿方法(AMP/ASE)在数据多样性增加时判别器易崩溃,导致 scaling 无法带来持续提升。
运动追踪的突破口:人类动作捕捉数据集(walking / running / dancing / fighting / tool-use …) 已经在数十年的研究中积累到规模——每帧都有明确的目标姿态,监督信号天然稠密, 每帧误差进入稠密追踪奖励,再通过 PPO 的策略梯度更新网络;不是把姿态误差穿过物理仿真器直接反传成“精确梯度”。
| 论文全称 | Supersizing mOtion tracking for Natural humanold Control(SONIC) |
| 数据规模 | 700 小时人类动作捕捉 → 过滤后 611 小时,100M+ 帧(50 fps),33 大类运动 |
| 模型规模 | 1.2M → 42M 参数 |
| 计算规模 | 2K → 21K GPU 小时(128 GPU 训练) |
| 追踪结果 | 99.6% 成功率(test-content OOD),99.2% sim-to-real 成功率 |
| 项目页 | nvlabs.github.io/GEAR-SONIC/ |
SONIC 是 MotionWAM 的底层运动引擎。MotionWAM 的 Motion DiT 预测的"全身运动 latent $m_t$", 其中的离散部分 $k_t$ 就是 SONIC 的 universal token;SONIC 负责把这个 token 解码成 29-DoF 关节命令。 MotionWAM = 上层感知-推理(Video DiT + Motion DiT)+ 下层运动执行(SONIC)。
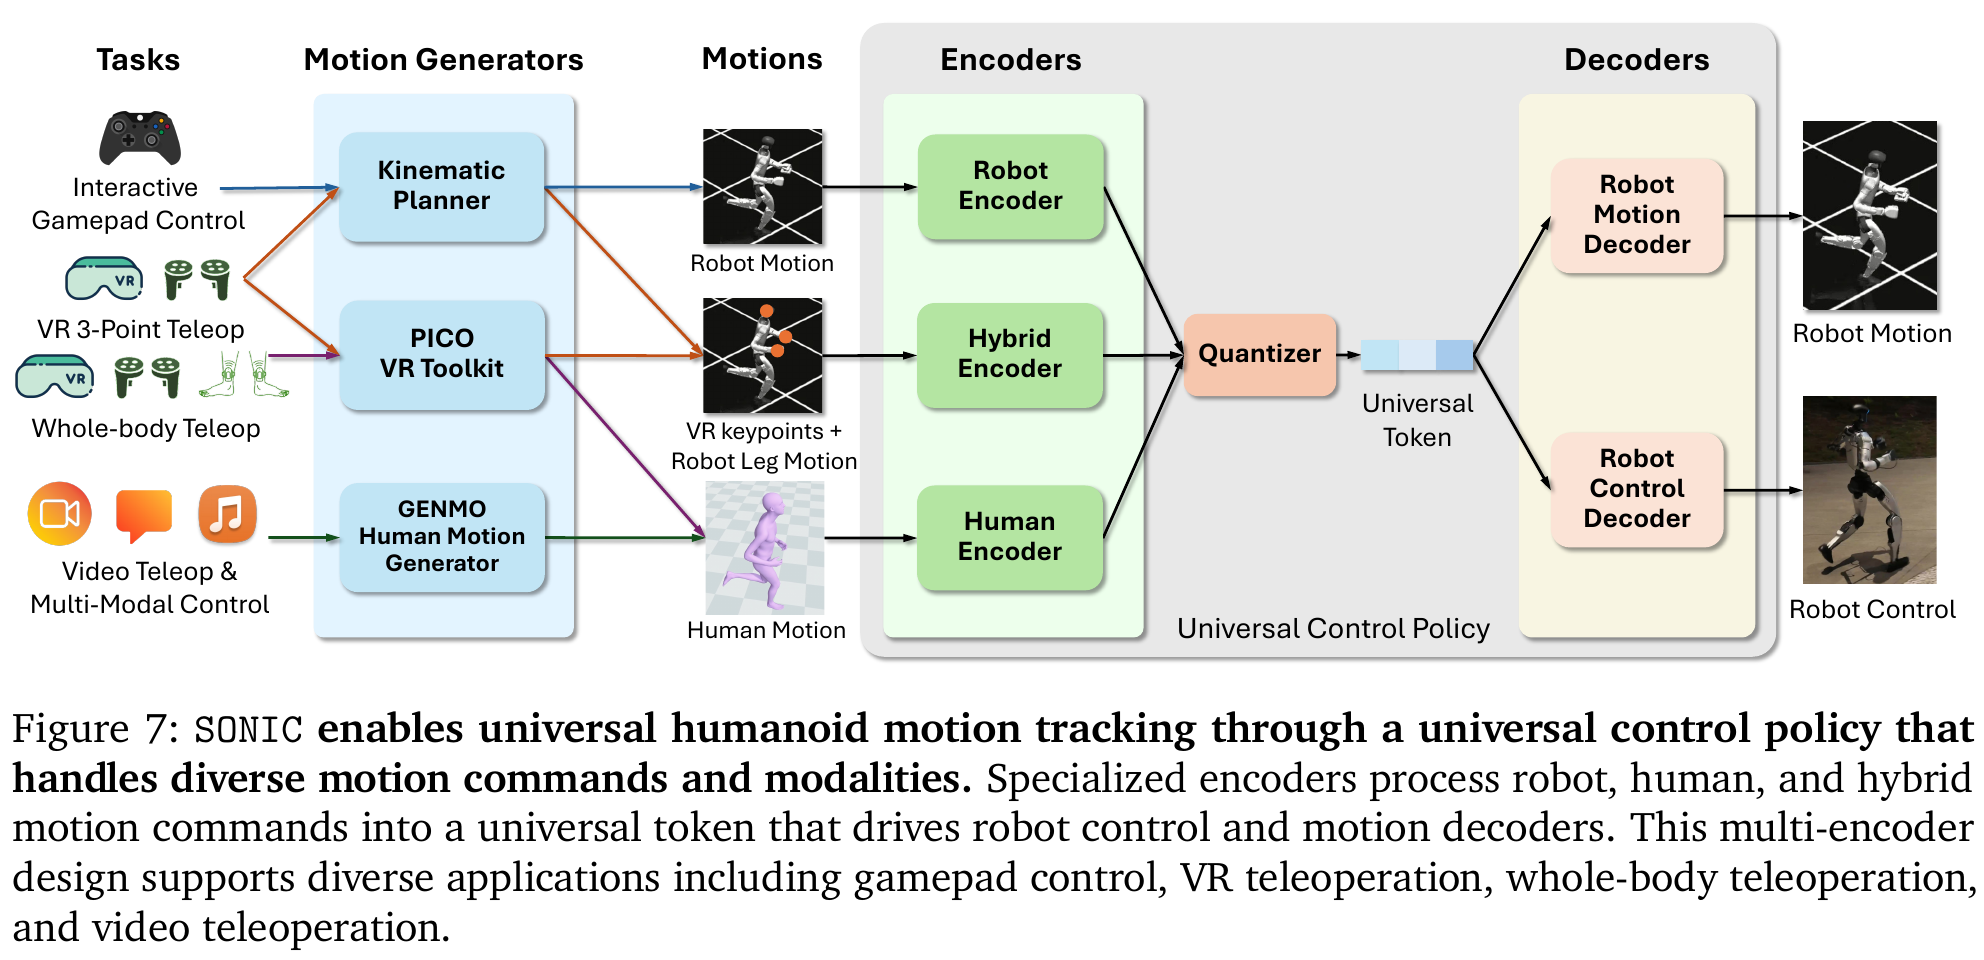
SONIC 的核心设计是一个通用控制策略(Universal Control Policy), 通过多专用编码器将异构的运动命令来源(机器人/人类/混合)统一映射到同一个量化 token, 再由单一策略解码为关节命令。整个系统架构如下:
策略在每时刻接收两类输入:
| $s_t^p$(本体感受) | 关节角度 $q_t$、关节速度 $\dot{q}_t$、根节角速度 $\omega_t$、重力向量 $g_t$、上一步动作 $a_{t-1}$;拼接 10 步历史作为时序上下文 |
| $s_t^g$(运动命令) | 三选一:机器人运动 $g_r$(joint positions + velocities)/ 人类运动 $g_h$(3D SMPL 关节)/ 混合运动 $g_m$(上身 keypoint + 下身机器人运动) |
所有量均在机器人局部坐标系下表示,采用 6D 旋转表示(Zhou et al. 2019)确保旋转不变性。
三种编码器均为 MLP,将各自输入映射到共享 latent 空间——这是跨模态对齐的关键。
SONIC 引入有限标量量化(Finite Scalar Quantization, FSQ)把连续 latent 压成一个 universal token $\mathbf{z}$,让来自不同输入模态(机器人 / 人类 / 混合)的运动命令 在同一个离散 token 空间里统一表达,单一策略用这个 token 驱动全身。
| VQ-VAE 的问题 | Codebook Collapse:大量 codebook 槽位空置不用,只有少数几个被激活。 需要额外的 commitment loss + EMA codebook 更新来缓解,训练不稳定, 本文选 FSQ 以减少这类维护,并实测其追踪误差更低;这不证明 VQ-VAE 与 PPO 在原理上不兼容。 |
| FSQ 的优势 | 没有独立 codebook,直接用有界 tanh + 四舍五入把连续值卡到离散档位。 straight-through 梯度估计天然兼容 PPO,无需额外 EMA 或 commitment loss, 训练全程稳定,在所有模型规模下未出现不稳定。 |
| Token 数量 | 2 个 token(每个独立量化) |
| 每 token 维度 | $D_z$(论文验证了多种配置) |
| 每维度档位 | 本版 SONIC 默认 FSQ-32-32:每维 32 档,每 token 32 维,共 64 维(Table 4) |
| 取值约定 | 用 $\mathcal Q_{32}$ 表示 32 个量化级;具体归一化与偶数级端点应以所用 checkpoint 的实现为准,不从维数反推。 |
| 梯度 | Straight-through estimation(前向 round,反向直接传梯度) |
把连续的声音频率量化为 12 个半音——FSQ 就在做类似的事:把连续的全身运动意图量化成 有限个离散"运动档位"。瓶颈化(只准 $L_z$ 档)是有意为之: 逼模型把全身运动压成紧凑、跨模态可复用的表示。 实验证明,预测 universal token 比直接预测 SMPL 姿态 产生更平滑、更安全的机器人行为(后者会有抖动和方向控制问题)。
运动追踪需要平衡稳定性(不摔倒)和精度(跟上参考姿态),单纯行为克隆无法保证物理可行性。 PPO 在物理仿真(Isaac Lab)中训练,自然获得稳定步态和接触动力学, 再用辅助损失(recon/token/cycle)约束 latent space。 PPO 梯度穿过 FSQ 的 straight-through estimator 更新编码器和量化器, 四项损失联合优化,端到端一个训练循环完成。
SONIC 在三个维度上系统验证了 scaling law(Fig. 2):数据规模、模型规模、算力规模。 所有测试集均隐藏于训练,用追踪成功率(Success Rate)和 MPJPE-L(关节位置误差)衡量。
test-content(OOD)成功率;SONIC MPJPE-L = 23.2mm,BeyondMimic = 39.1mm(41% 降低)
| 测试条件 | 123 条多样运动序列,真实 Unitree G1 |
| 真实 vs 仿真成功率 | 99.2% (real) vs 100.0% (sim) |
| MPJPE-L 上身 | 22.2mm (real) vs 21.8mm (sim),gap 极小 |
| MPJPE-L 足部 | 53.7mm (real) vs 29.0mm (sim),足部接触动力学差异最大 |
运动追踪的监督信号是稠密逐帧的——每一帧都告诉模型"你离目标姿态差了多少"。 对比 AMP/ASE(判别器随数据增加易崩溃),或任务特定奖励工程(每个行为需要重设计), 运动追踪的学习信号始终有效,所以 scaling 带来持续提升。 这也是 LLM 用 next-token prediction 能 scale 的同等道理:稠密监督 + 明确标签 = 可扩展任务。
Universal token 的威力在于:不修改策略权重,只换上游的运动生成模块, 同一个 SONIC 就能支撑完全不同的控制接口。
实时生成运动规划,支持 0–6 m/s 速度、360° 方向、多种风格(步行/奔跑/醉步/受伤步态)。 Planner 推理 <5ms(笔记本),每 100ms 重规划一次,保证高响应性。 还支持蹲下(骨盆高度 0.3–0.8m)、跪姿、匍匐(肘膝爬行,全向 0–0.5 m/s)。
输入是什么:当前任务提供的原始观测、指令、机器人状态或训练数据。先明确这些输入,才能判断后面的结论是否用了部署时拿不到的信息。
这一步究竟做什么:实时生成运动规划,支持 0–6 m/s 速度、360° 方向、多种风格(步行/奔跑/醉步/受伤步态)。 Planner 推理 <5ms(笔记本),每 100ms 重规划一次,保证高响应性。 还支持蹲下(骨盆高度 0.3–0.8m)、跪姿、匍匐(肘膝爬行,全向 0–0.5 m/s)。
输出到哪里:可发送给机器人控制器的动作,以及执行后重新观测到的真实状态。这个结果会交给下一步“② VR 全身遥操作(Whole-Body Interface)”继续处理。
为什么不能省略:机器人动作会改变下一次观测;只有执行后重新读取现实,才能发现预测误差并阻止错误连续累积。
PICO 头显 + 两个踝关节 tracker + 手柄 → SMPL 全身姿态 → 人类编码器 $\mathcal{E}_h$ → token。 覆盖完整身体动力学(侧展、前伸、单腿跪、劈叉、功夫步……)。 同时也支持"三点遥操"(只有头 + 双腕 keypoint,下身由 Planner 自动生成)。
输入是什么:来自上一步“① 互动导航控制(Kinematic Planner)”的产物:可发送给机器人控制器的动作,以及执行后重新观测到的真实状态。本步骤还会按论文设置读取当前条件、时间步或训练信号。
这一步究竟做什么:PICO 头显 + 两个踝关节 tracker + 手柄 → SMPL 全身姿态 → 人类编码器 $\mathcal{E}_h$ → token。 覆盖完整身体动力学(侧展、前伸、单腿跪、劈叉、功夫步……)。 同时也支持"三点遥操"(只有头 + 双腕 keypoint,下身由 Planner 自动生成)。
输出到哪里:一组比原始输入更紧凑的内部特征;它不是最终动作或画面。这个结果会交给下一步“③ 视频遥操作(Video Teleoperation)”继续处理。
为什么不能省略:它承担上下两步之间的接口;缺少它,前一步产生的信息无法以正确格式或正确含义传到下一步。
单目摄像头实时估计人体姿态(≥60 FPS),通过 $\mathcal{E}_h$ 转为 token 驱动机器人。 无需专用 MoCap 硬件,高保真姿态和时序的精确模仿。
输入是什么:来自上一步“② VR 全身遥操作(Whole-Body Interface)”的产物:一组比原始输入更紧凑的内部特征;它不是最终动作或画面。本步骤还会按论文设置读取当前条件、时间步或训练信号。
这一步究竟做什么:单目摄像头实时估计人体姿态(≥60 FPS),通过 $\mathcal{E}_h$ 转为 token 驱动机器人。 无需专用 MoCap 硬件,高保真姿态和时序的精确模仿。
输出到哪里:一组比原始输入更紧凑的内部特征;它不是最终动作或画面。这个结果会交给下一步“④ 文字/音乐控制(Multi-Modal,GEM 生成器)”继续处理。
为什么不能省略:它承担上下两步之间的接口;缺少它,前一步产生的信息无法以正确格式或正确含义传到下一步。
GEM(Generative Embodied Motion)从自然语言或音乐生成目标运动, SONIC 追踪执行。"Acts like a monkey" / "Punches with his left arm" / 根据节拍和旋律跳舞——无需重新训练控制器,只需换运动生成模块。
输入是什么:来自上一步“③ 视频遥操作(Video Teleoperation)”的产物:一组比原始输入更紧凑的内部特征;它不是最终动作或画面。本步骤还会按论文设置读取当前条件、时间步或训练信号。
这一步究竟做什么:GEM(Generative Embodied Motion)从自然语言或音乐生成目标运动, SONIC 追踪执行。"Acts like a monkey" / "Punches with his left arm" / 根据节拍和旋律跳舞——无需重新训练控制器,只需换运动生成模块。
输出到哪里:一个或多个候选未来、动作或轨迹,以及必要的中间状态。这个结果会交给下一步“⑤ VLA 驱动 Loco-Manipulation(GR00T N1.5)”继续处理。
为什么不能省略:机器人动作会改变下一次观测;只有执行后重新读取现实,才能发现预测误差并阻止错误连续累积。
将 GR00T N1.5 VLA 模型接到 SONIC universal token 接口, VLA 预测 78 维动作(64 维 universal token + 14 维手部关节)。 5 个 Loco-Manip 任务平均 75% 成功率,包括: 开踏板垃圾桶(需要精准单脚踩踏板 + 另一脚平衡,70%), 可乐罐扔垃圾桶(5 技能串联,60%)。
输入是什么:来自上一步“④ 文字/音乐控制(Multi-Modal,GEM 生成器)”的产物:一个或多个候选未来、动作或轨迹,以及必要的中间状态。本步骤还会按论文设置读取当前条件、时间步或训练信号。
这一步究竟做什么:将 GR00T N1.5 VLA 模型接到 SONIC universal token 接口, VLA 预测 78 维动作(64 维 universal token + 14 维手部关节)。 5 个 Loco-Manip 任务平均 75% 成功率,包括: 开踏板垃圾桶(需要精准单脚踩踏板 + 另一脚平衡,70%), 可乐罐扔垃圾桶(5 技能串联,60%)。
输出到哪里:一组比原始输入更紧凑的内部特征;它不是最终动作或画面。这是图中这条链路的最终产物,随后会进入真实执行、模型更新或指标评测。
为什么不能省略:它把前面得到的内部结果落实为可执行动作、可训练模型或可解释指标,完成从方法到结果的最后一步。
MotionWAM 不重新发明底层控制——它把 SONIC 的 universal token 直接作为 Motion DiT 的预测目标,把 SONIC 本身当作解码器(decoder)。 两篇工作是垂直分工:SONIC 负责"从 token 到身体运动", MotionWAM 负责"从视觉+语言到 token"。
| SONIC 的 universal token $\mathbf{z}$ | 对应 MotionWAM 中的 $k_t$($m_t$ 的离散部分,2 token × 32 levels × $D_z$ dim) |
| MotionWAM 的 $m_t^{\text{cont}}$ | SONIC 覆盖不到的灵巧手通道(夹爪 / 灵巧手),MotionWAM 额外追加的连续部分 |
| SONIC 的 $\mathcal{D}_c$ | MotionWAM Stage 3 公式 (6) 中的 SONIC 解码步骤:$(m_t^{\text{cont}}, k_t) \xrightarrow{\text{SONIC}} \mathbf{a}_t$ |
| Stage 3 遥操作流水线 | PICO VR → SMPL 24 关节 → SONIC retarget → 29-DoF 关节命令(50 Hz),和 SONIC §2.4 VR 遥操作接口一致 |
SONIC 缺乏对安全性和能耗的正式处理,在极端动态运动下(如急速换向 6→-6 m/s)追踪器可能失衡。 足部接触精度(sim-to-real gap 最大:53.7mm real vs 29.0mm sim)仍是最大挑战。 上层 VLA(如 MotionWAM)如果依赖 SONIC,也继承了这些限制。